
【記事の要約(ここだけでもポイントは掴めます)】
ChatGPT や Gemini、Perplexity といった生成 AI での言及・引用(いわゆる「AI 可視性」)を、KPI としている企業が増えています。しかしその一方で「その数字を信じていいのか」「何から手をつければいいのか」で止まってしまう現場の声も少なくありません。
- AI プロンプトの実データを公開しているのは、主要プラットフォームの中で Microsoft Copilot のみ。ほとんどの AI 可視性指標はあくまで「推定値」である
- Ahrefs(エイチレフス)は Google 検索ボリュームを基準にした独自指標「AI adjusted volume(AI 調整済みボリューム)」を採用し、向き・不向きを自ら明確に線引きしている
- Search Engine Journal(SEJ)は「メンション(言及)」と「レコメンド(推薦)」を切り分けて監査する、自社でできる4ステップの手順を提示している
- 監査は一度やって終わりではなく、継続的な計測と改善のサイクルに載せて初めて意味がある
まずは自社の AI 可視性データが「何を根拠に、何を推定しているか」を確認することが最初の一歩です。
なぜ「AI可視性の数字」は鵜呑みにできないのか
AIプロンプトの実データを公開しているのは、主要プラットフォームの中でMicrosoftのCopilotのみ
Ahrefs は2026年8月17日、自社ブログで「AI adjusted volume(AI 調整済みボリューム)」という独自指標の考え方を公開しました。出発点にあるのは、「AI に何をどれだけプロンプトされているか」を正確に把握できるデータが、実は公開されていません。
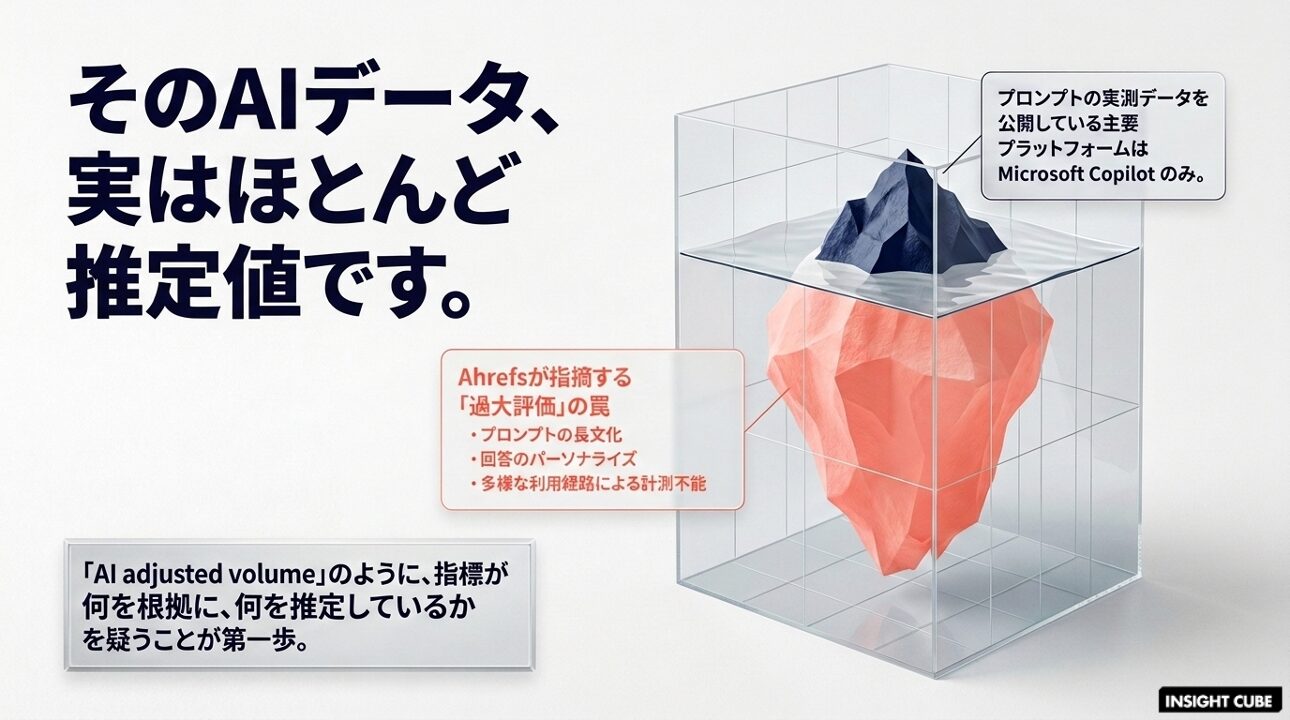
ChatGPT や Gemini、Claude、Perplexity といった主要な生成 AI プラットフォームは、Microsoft の Copilot を除き、ユーザーが実際にどんな問いを投げているかというクエリデータを一切公開していません。
プロンプトの実測データをそのまま使うと、需要を過大評価しやすい
各 AI 可視性ツールは、それぞれ異なる方法でこの需要を推定しています。Ahrefs が指摘するのは、実測に近い「AI プロンプトデータ」をそのまま需要推定に使う手法は、過大評価に陥りやすいという点です。理由は次の3つに整理できます。
- プロンプトは長文化する: AI は情報検索だけでなく、旅行計画やコード生成、画像生成など多様な用途で使われるため、同じ話題でも表現が大きくばらつきます
- 回答がパーソナライズされる: 直前までの会話の文脈を踏まえて回答が変わるため、同じ質問でも実際のプロンプトは一様ではありません
- 利用経路が多様: ブラウザだけでなく、デスクトップアプリ、API、サードパーティ連携、チャットボット経由など、計測できない経路からの利用が多くあります
こうした事情から、Ahrefs は AI プロンプトの実測データではなく、Google 検索ボリュームを基準に、AI プラットフォームごとのトラフィック比率を掛け合わせて需要を推定する「AI adjusted volume(AI 調整済みボリューム)」を採用しています。
Google 検索が依然として検索市場の9割以上を占め、豊富な公開データ(Search Console、Keyword Planner など)に裏付けられている点を、推定の拠り所として選んだ形です。
Ahrefs自身が「向いている用途」と「向いていない用途」を明確に線引きしている
重要なのは、Ahrefs 自身がこの指標の向き・不向きを明確に線引きしている点です。
向いている用途は、競合とのブランド可視性・シェアオブボイス(特定の話題における自社言及の占有率)のベンチマーク、注目度の高いトピックの特定、AI プラットフォームごとの流入インパクトの比較、優先すべき施策の絞り込みです。
一方、向いていない用途は、AI 検索市場そのものの規模推定や、特定の AI 回答を実際に何人が見たかという実数の把握です。
「AI 可視性の数字」を見るときは、その裏側にある算出方法まで踏み込んで確認する視点が欠かせません。 他社ツールの数値を比較検討する際も、「何を根拠に、何を推定しているか」という前提を疑う姿勢が第一歩になります。
SEOで1位でもAIには推薦されない、という現実
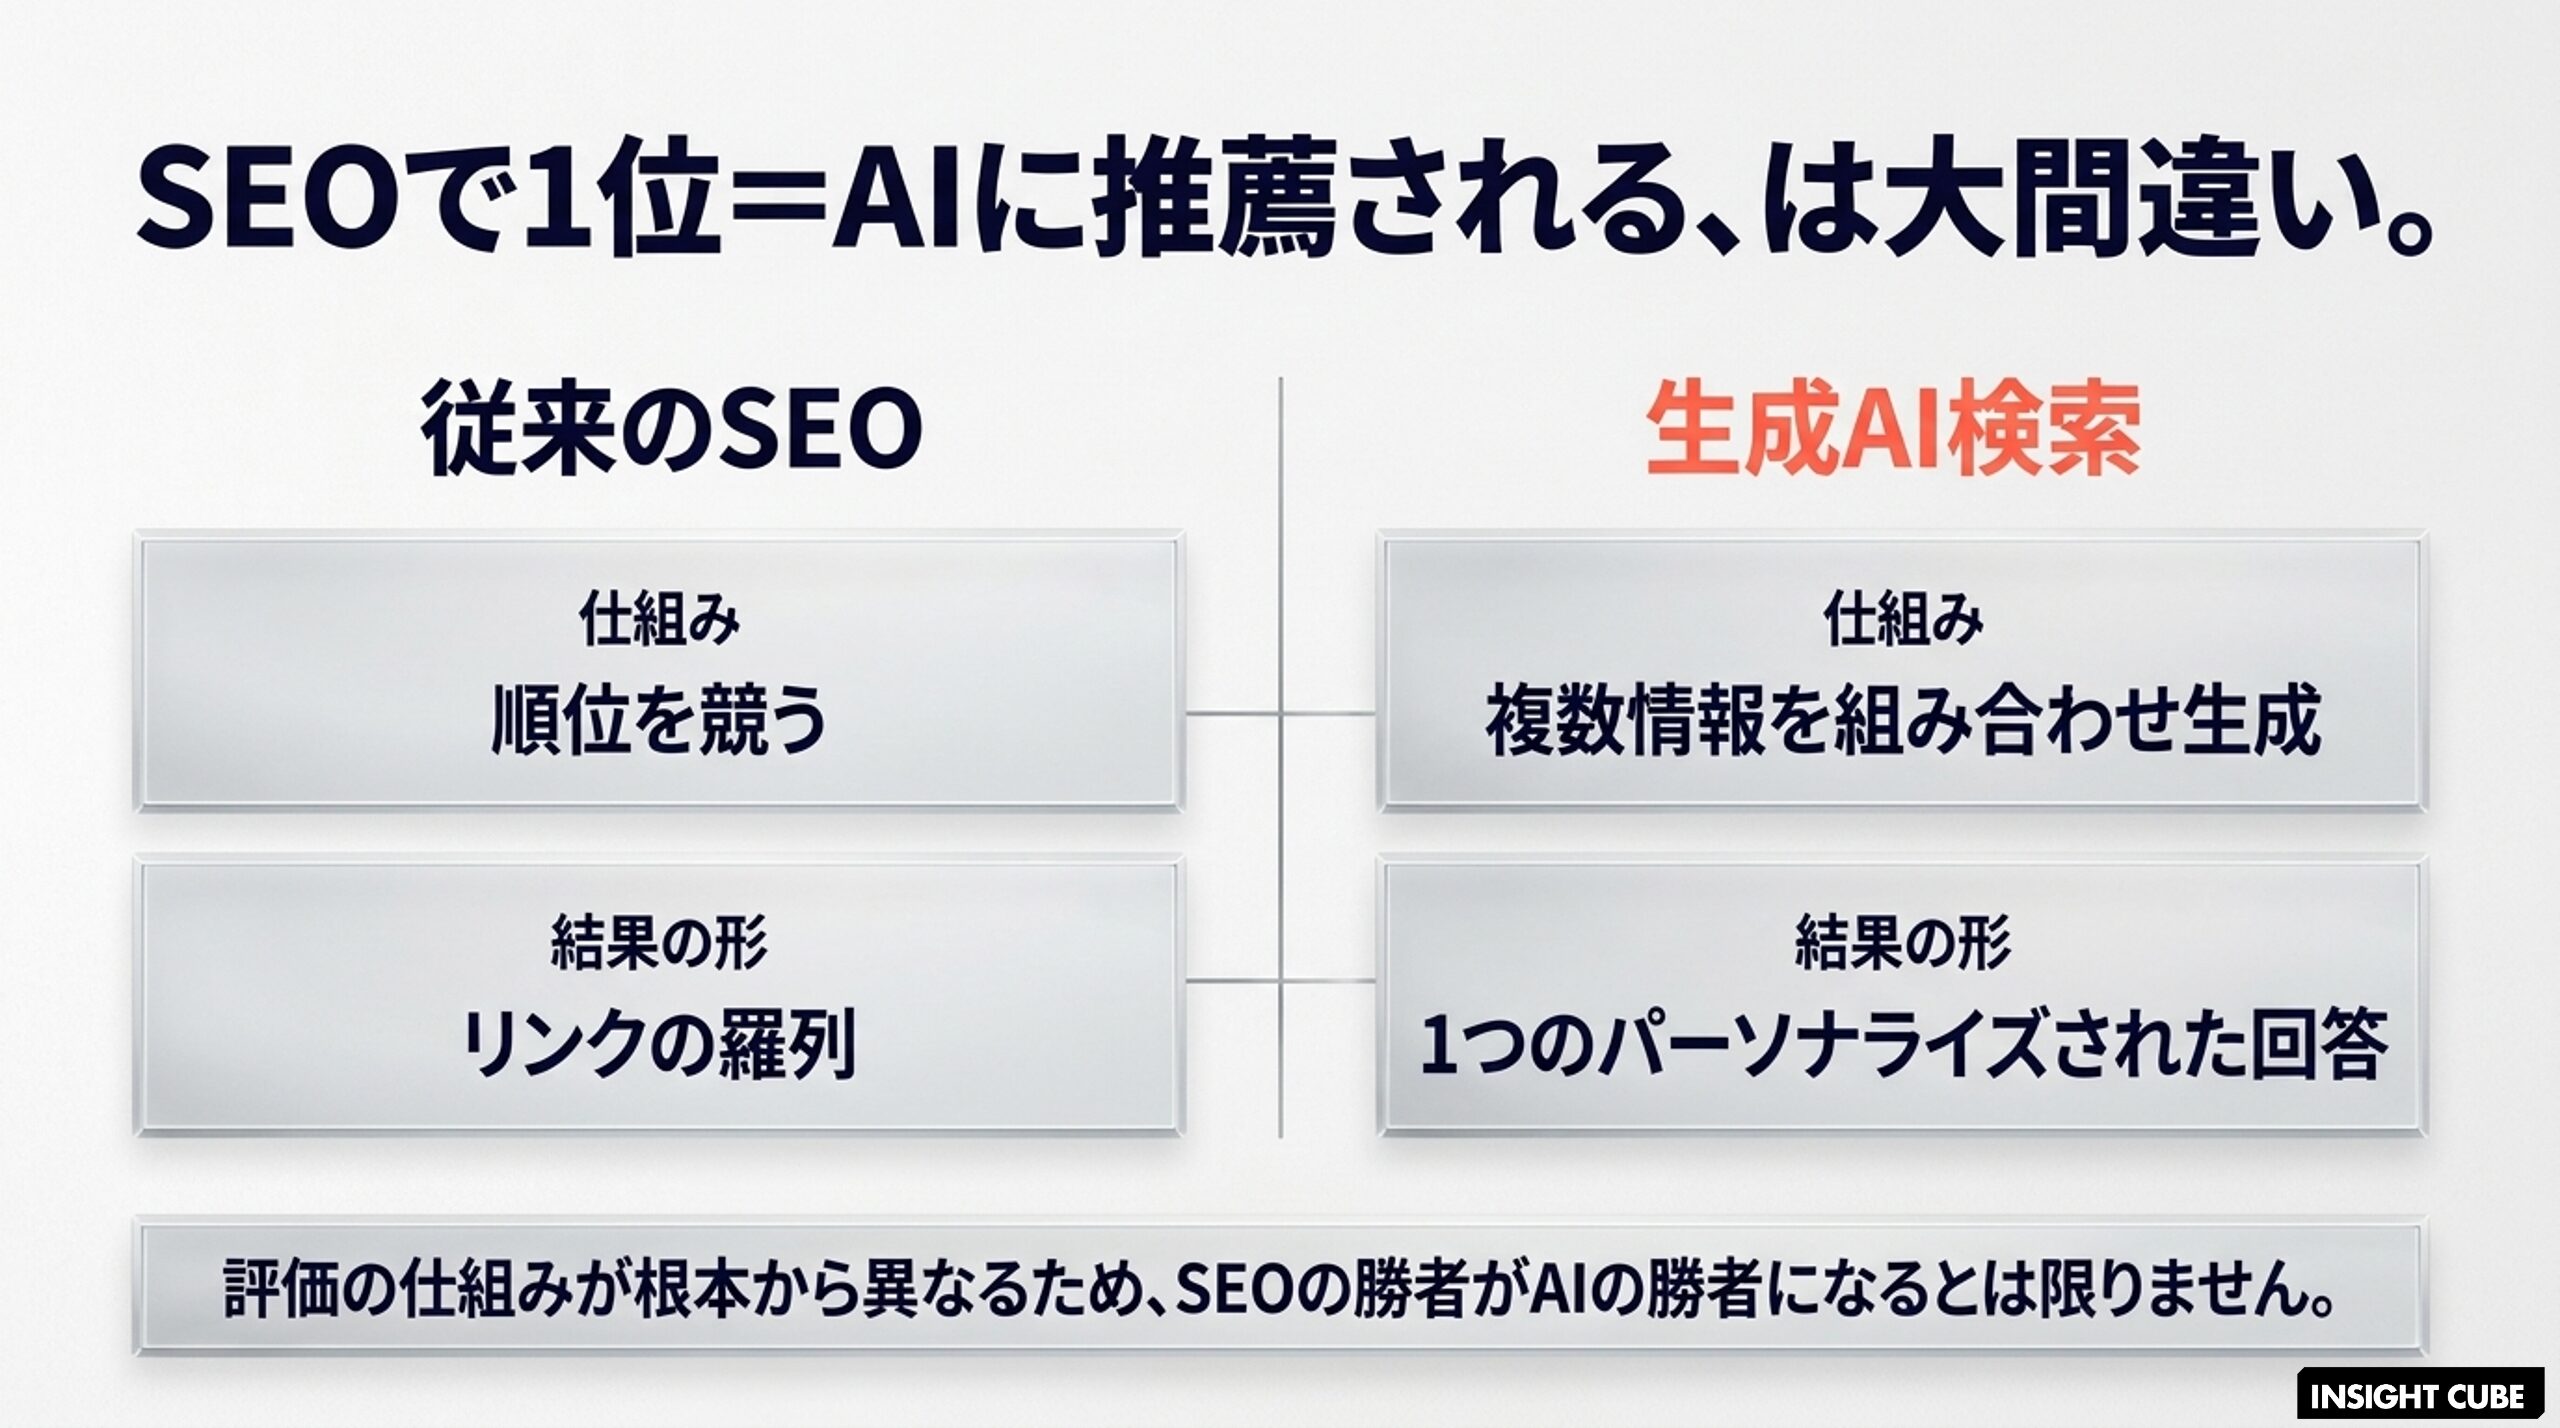
従来のSEOとAI検索は、そもそも評価の仕組みが異なる
指標の前提を押さえたところで、次に問題になるのが「では、AI 可視性をどう監査すればいいのか」という実行の話です。この点については、Search Engine Journal(SEJ)が2026年9月4日に公開した記事が具体的な手順を示しています。
記事はまず、従来の SEO ランキングと AI 検索の推薦ロジックが、そもそも別物であるという前提を整理しています。従来の SEO は、キーワード関連性やバックリンク、技術的なサイト構造といった要素を評価し、検索結果ページ上での自社ページの「順位」を競う仕組みです。
一方、ChatGPT や Gemini、Perplexity といった生成 AI は、質問のたびに複数の情報源を組み合わせて新しい回答を生成します。この生成ロジックの違いこそが、「SEO では1位なのに、AI には推薦されない」という現象の正体だとされています。
「メンション」と「レコメンド」は別の指標として扱う必要がある
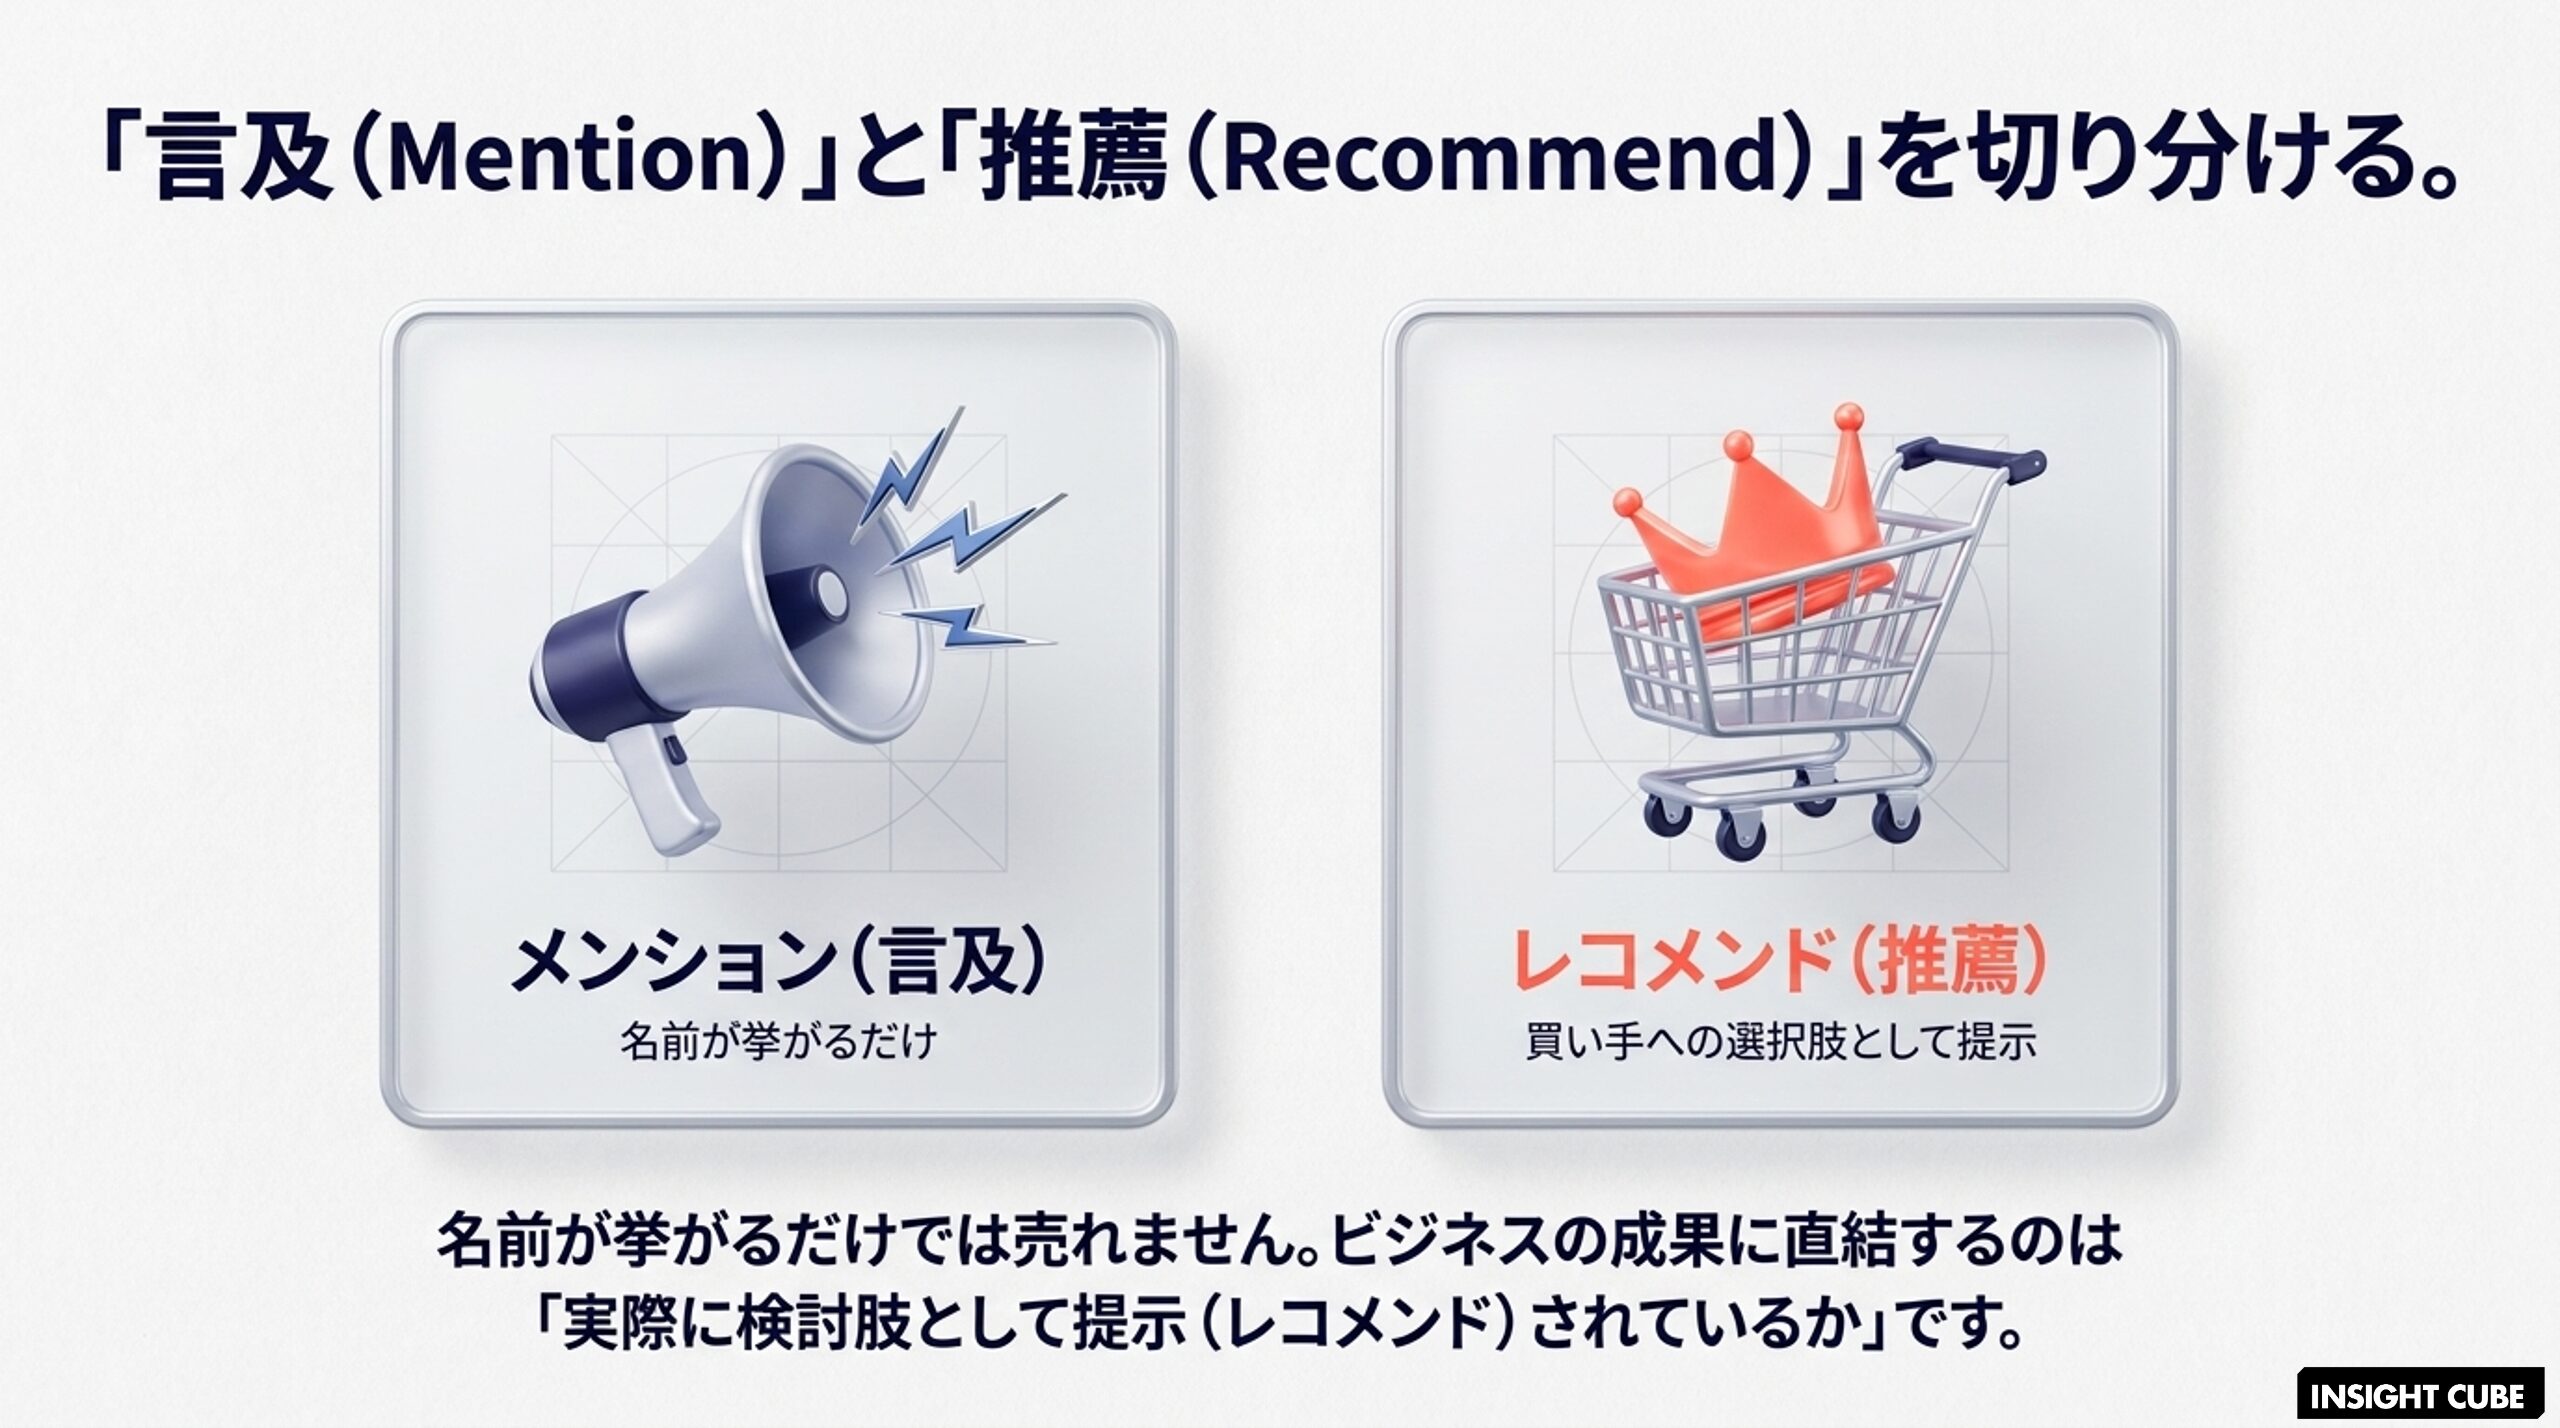
ここで整理しておきたいのが、「メンション」と「レコメンド」の違いです。メンションとは、AI の回答内でブランド名が言及されている状態を指します。
一方、レコメンドとは、買い手が検討すべき選択肢として、実際に提示されている状態を指します。
ブランドがメンションされる頻度は高くても、レコメンドされる頻度はほとんどない、というケースは珍しくありません。ビジネスの成果に直結するのはレコメンドであり、監査ではこの2つを切り分けて追う必要があります。
「メンション」と「レコメンド」に関して、INSIGHT CUBE では、LLMOA(エルモア)で独自調査をしたデータを公開しています。
 「出れば1位」でも「出現率」は上がらない|LLMOA(エルモア)が計測した11サービス分野データが示す共通課題
自社でできるAI可視性監査、4つのステップ
SEJ の記事が示す監査フレームワークは、大きく4つのステップに分けられます。
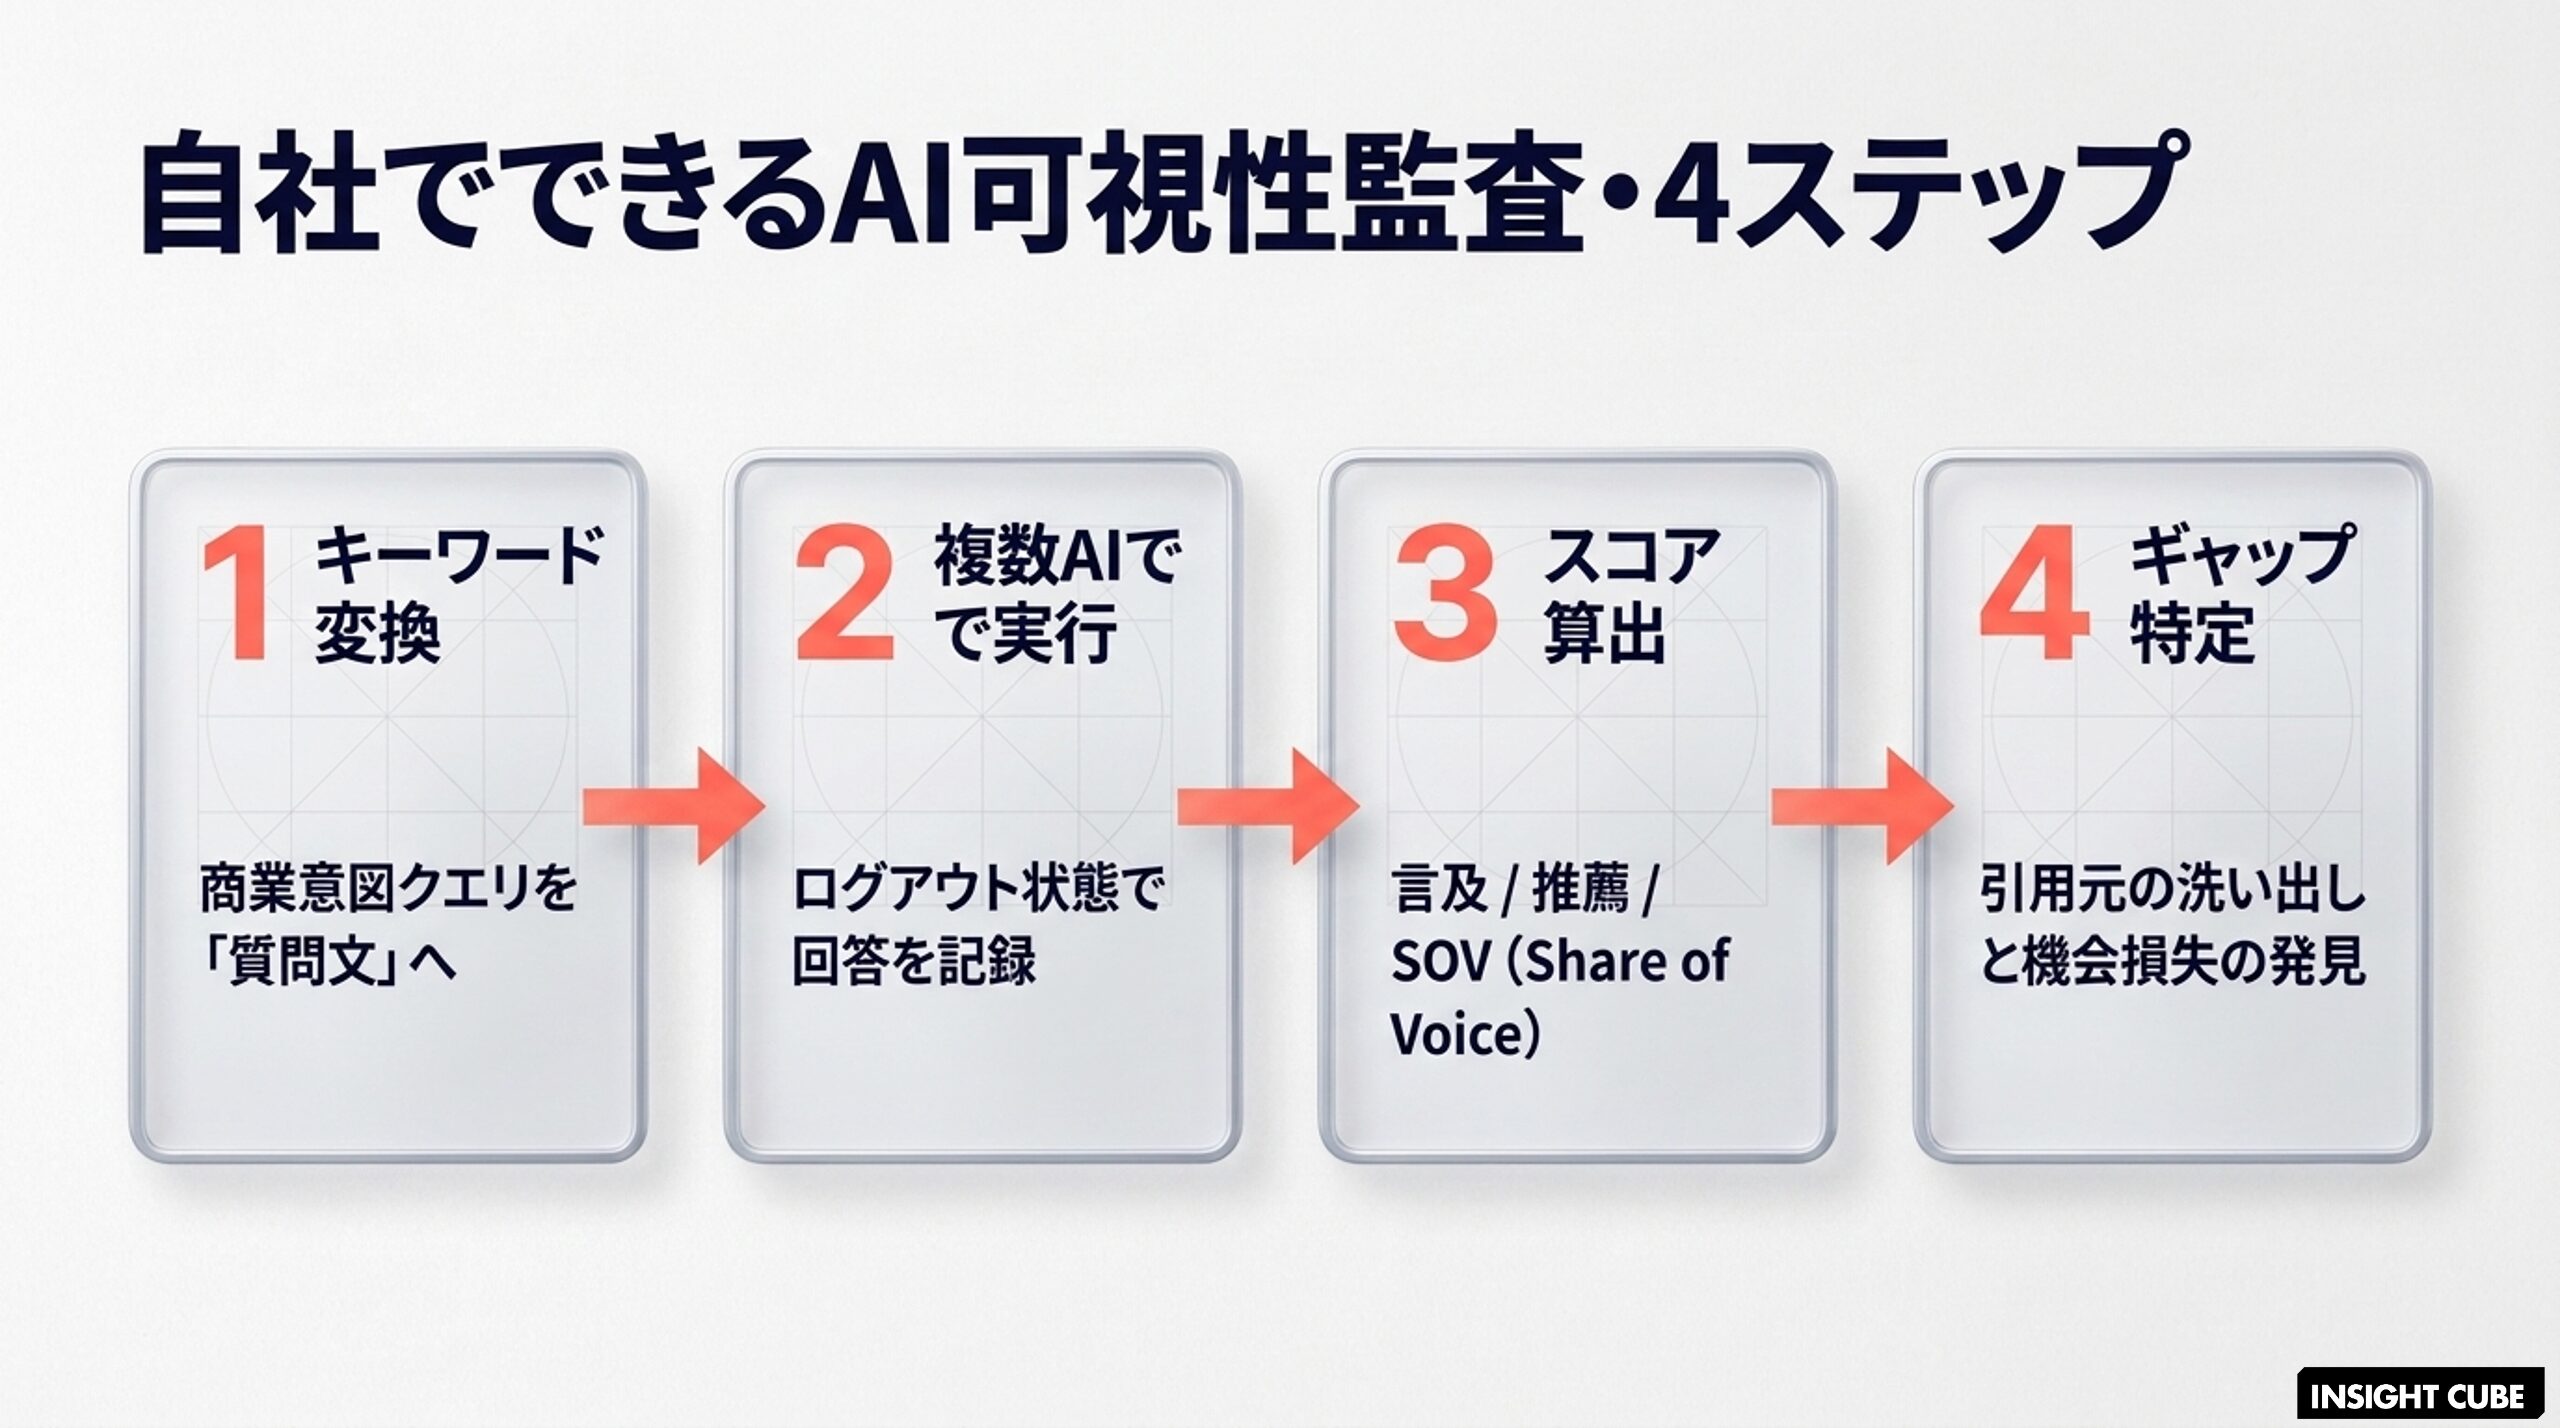
ステップ1|SEOキーワードをAI向けプロンプトに変換する
Search Console のパフォーマンスレポートから、直近3ヶ月で平均掲載順位10位以内の商業意図クエリ(「おすすめ」「料金」など比較・購買検討につながる語を含むもの)を抽出します。
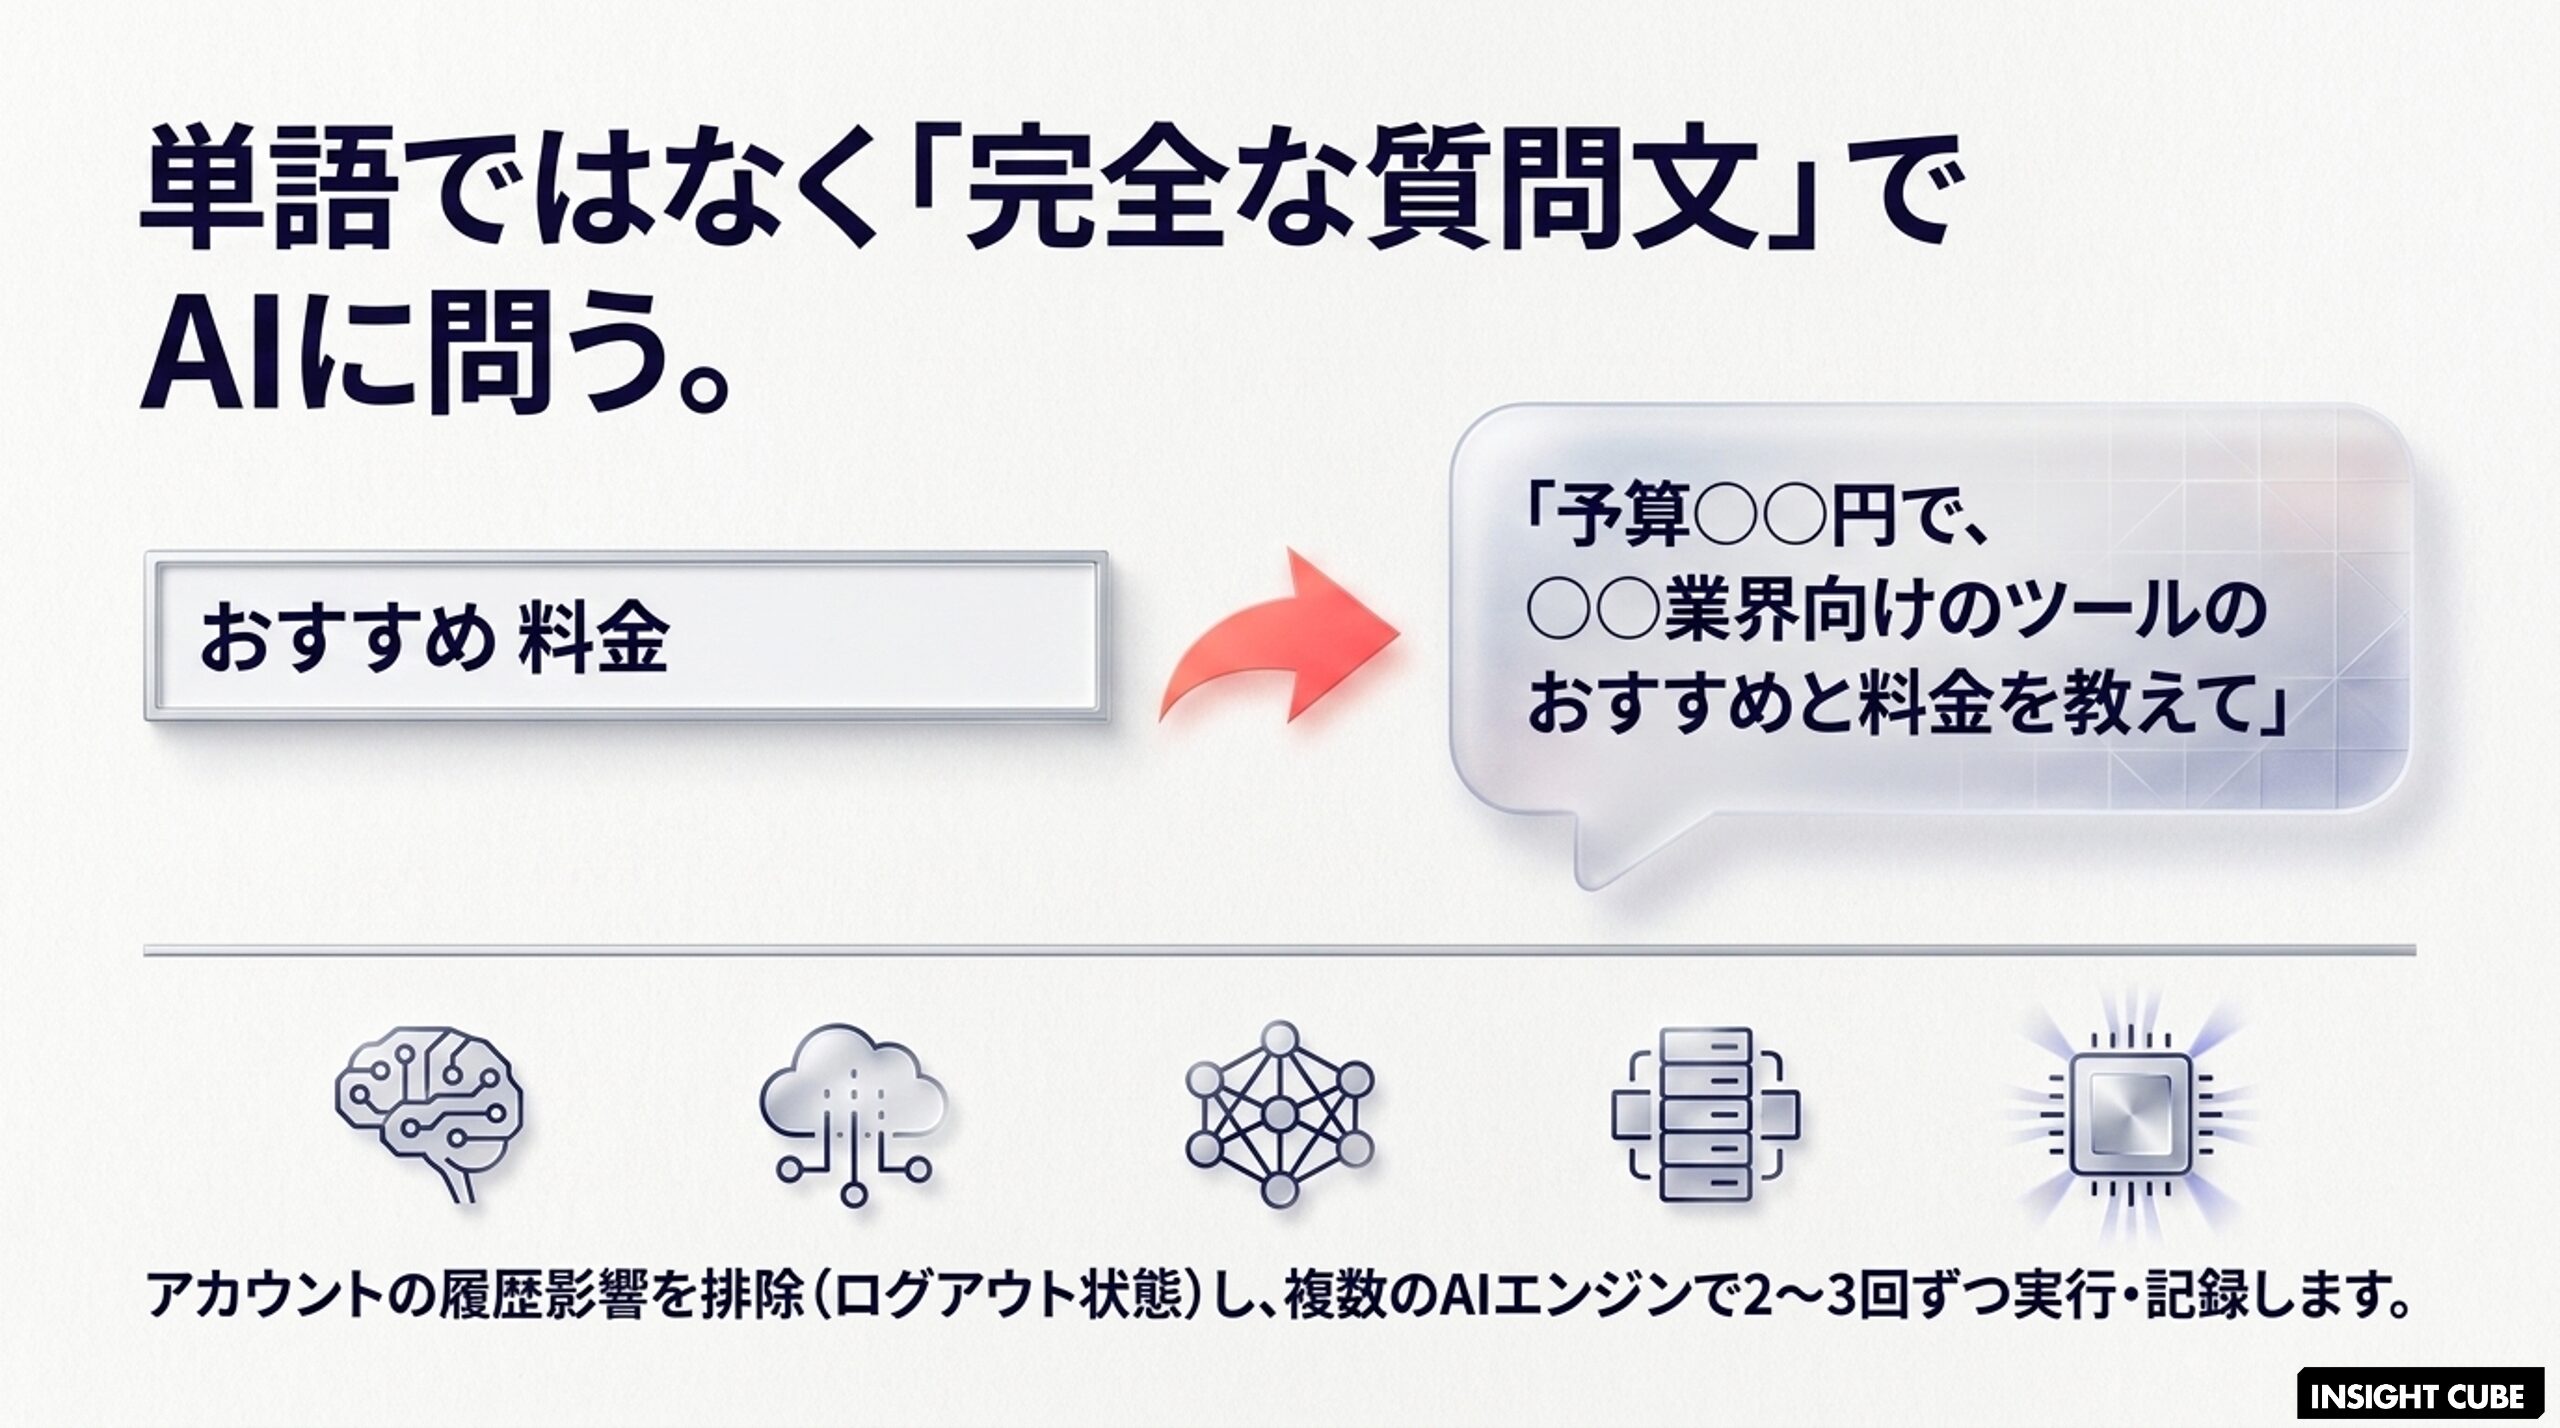
それを、実際のユーザーが AI に問いかけるような自然な文章に書き換えます。単なるキーワードの羅列ではなく、業種や予算、具体的な状況を含めた「完全な質問文」にすることがポイントです。
ステップ2|複数のAIエンジンで実行し、回答を記録する
書き換えたプロンプトを、ログインを外した状態(アカウントの会話履歴の影響を排除するため)で、各 AI エンジンごとに2〜3回ずつ実行します。
そのうえで、回答した AI エンジン、言及されたブランド名とその順序、自社ブランドの有無、上位3件以内に入っているか、引用されているドメインの6項目を記録します。
ステップ3|メンション率・レコメンド率・シェアオブボイスを算出する
記録したデータから、次の3指標を算出します。
- メンション率=メンションされた回数 ÷ 実施したプロンプト数
- レコメンド率=上位3件以内に入った回数 ÷ 実施したプロンプト数
- シェアオブボイス=自社の言及回数 ÷ 全ブランドの言及回数
これらを AI エンジン別に算出したうえで、平均した複合スコアも併記するとよいとされています。
ステップ4|ギャップリストと引用元の内訳を洗い出す
自社が上位10位以内にランクインしているにもかかわらず、AI 回答で言及されていないプロンプトを「ギャップリスト(取りこぼしている検討機会の一覧)」として抽出します。
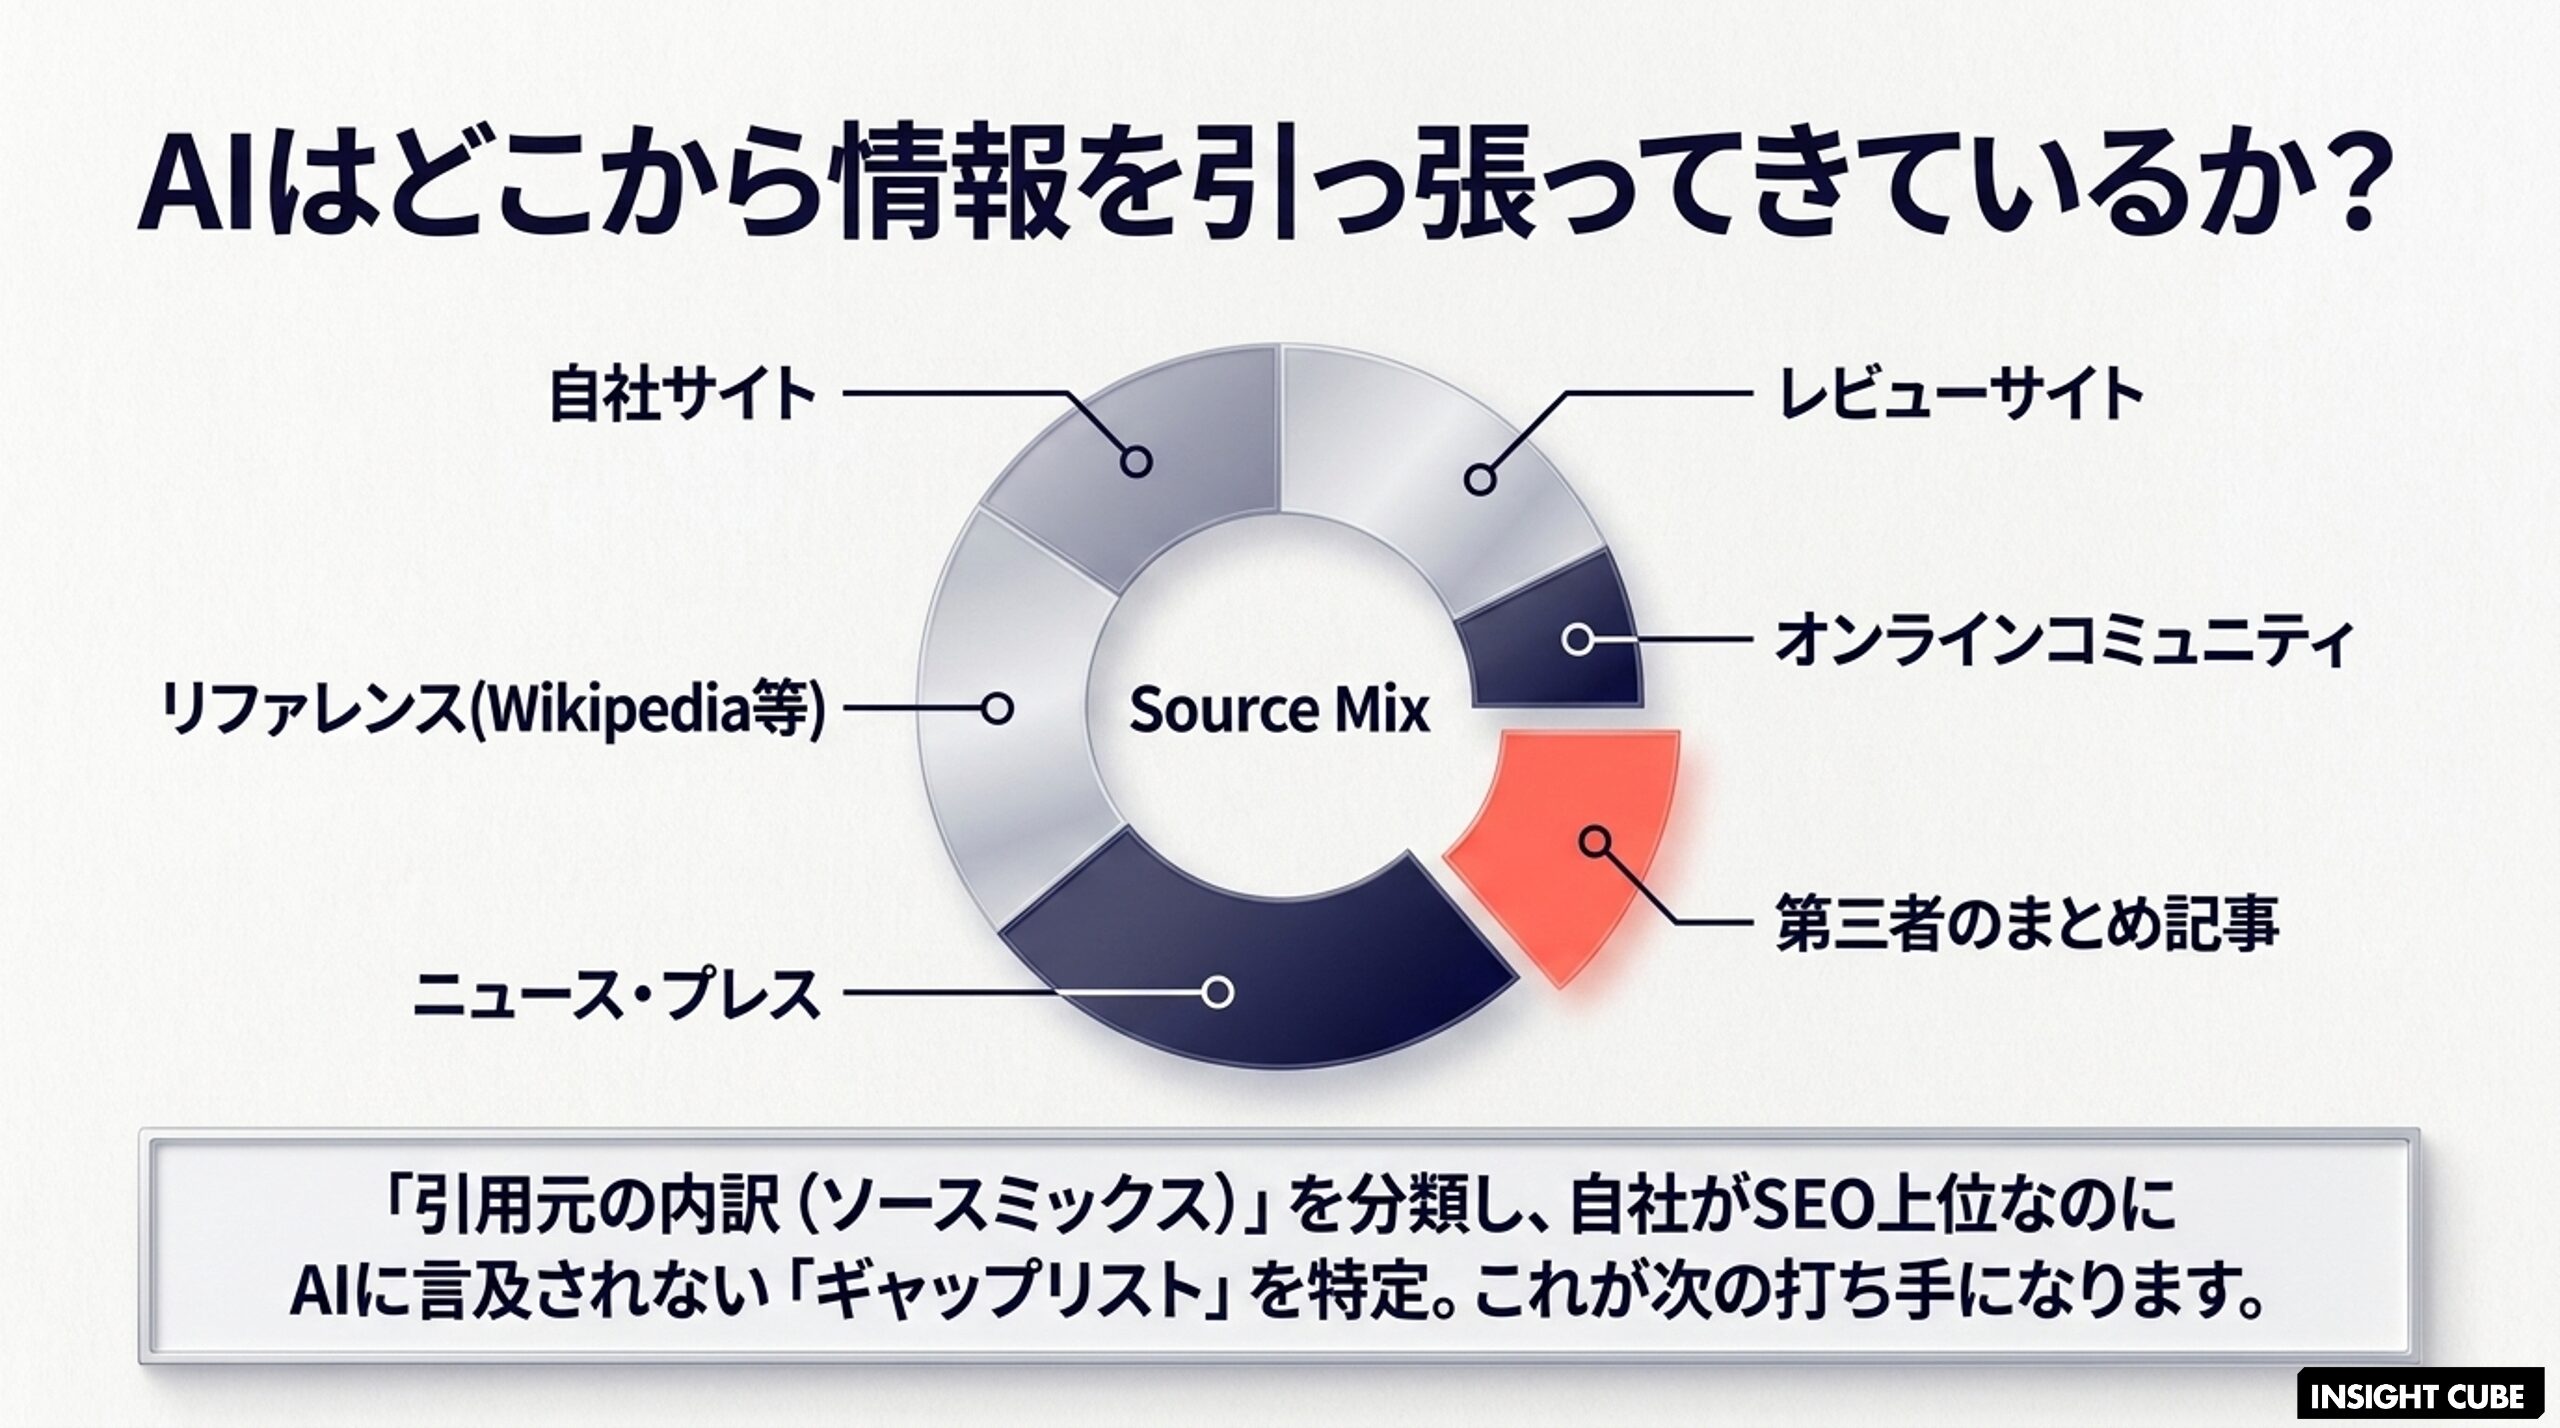
あわせて、引用されているドメインを以下の6タイプに分類・集計します。
①レビューディレクトリ(BtoB向け:ITトレンド、BOXIL SaaSなど/消費財向け:マイベスト、価格.comなど)
②オンラインコミュニティ(Reddit 等)
③第三者のまとめ記事
④ニュース・プレス
⑤Wikipedia などのリファレンスページ
⑥自社サイト
これが「引用元の内訳(ソースミックス)」であり、次にどこへ手を打つべきかの判断材料になります。
手作業の監査には限界がある
複数モデル×複数プロンプトを日次で継続するのは現実的に難しい
ここまでの4ステップは有効な手法ですが、実際にやってみると負荷の大きさに気づきます。複数の AI モデルに対して複数のプロンプトを実行し、回答内容を毎回記録・分類する作業を、日次や週次で継続するのは現実的に難しいものです。
しかも AI 検索の露出状況は日々変化するため、単発の監査で終わらせては意味がなく、継続的な計測と改善のサイクル(PDCA)に載せる仕組みが必要になります。
この「計測はできても、そこから改善につながらない」という壁は、実際に手を動かしている企業でも共通して直面する課題です。
PDCAサイクルを回すために有効な手段として LLMOA(エルモア)を活用する
4ステップの監査プロセスを、手動作業なしで日次実行できる
前章で挙げた4ステップ(プロンプト変換・複数エンジンでの実行・スコア算出・ギャップ抽出)は、手作業で継続するには負荷が大きいという課題がありました。

グラッドキューブの LLMOA(エルモア)は、この一連のプロセスを ChatGPT・Gemini・Google AI Overview・Google AI Mode・Perplexity の主要5モデルを横断して自動化し、プロンプト単位・日別での言及有無や採用順位、引用元、競合比較を継続的に記録します。
メンション率・レコメンド率・引用元の内訳を、都度の手動集計なしで確認できる
SEJ が示した「メンション率」「レコメンド率」「ソースミックス(引用元の内訳)」といった指標は、本来であれば回答を都度記録し分類する手間がかかります。
LLMOA はこれらを自動集計するため、監査のたびにゼロから作業をやり直す必要がありません。
実際にPDCAへつなげた分析事例は、別記事で詳しく解説しています
LLMOA の計測データを用いた分析では、言及率29.7%という出現面の課題から、語られ方・順位・成果への接続まで4つの視点で分解し、6ヶ月のフェーズ設計に落とし込んだ実例を紹介しています。
詳しい数値と分析プロセスは、関連記事「『自社で28日間・2,133回 AI 検索の可視性を計測した結果』を公開」をご覧ください。
 「自社で28日間・2,133回 AI 検索の可視性を計測した結果」を公開|LLMOA(エルモア)のサンプルレポートで見る「計測から改善まで」の全プロセス
LLMOAで、計測から改善までのサイクルを自動化する

重ねてになりますが、手作業でのAI可視性監査は、複数のAIモデル×複数のプロンプトを継続的に記録・分類する負荷の大きさが壁になります。
グラッドキューブの LLMOA(エルモア)は、ChatGPT・Gemini・Google AI Overview・Google AI Mode・Perplexity の主要5モデルを横断して、プロンプト単位・日別での言及有無や採用順位、引用元、競合比較、AI 経由の流入・CV までを一つの画面で確認できます。
「そもそも自社が AI にどう言及・引用されているか分からない」という段階であれば、まず計測から始めることが第一歩になります。

まとめ:指標への疑いと、実行のステップの両方を押さえる
以下、本記事のまとめとなります。
- AI プロンプトの実データを公開しているのは、主要プラットフォームの中で現在は Microsoft Copilot のみ。ほとんどの AI 可視性指標は推定値であり、その算出方法まで確認する視点が欠かせない
- 「メンション(言及)」と「レコメンド(推薦)」は別の指標であり、切り分けて監査する必要がある
- 自社でできる監査は、①プロンプト変換→②複数 AI エンジンでの実行→③スコア算出→④ギャップリストと引用元の洗い出し、という4ステップに整理できる
- 監査は単発で終わらせず、継続的な計測と改善のサイクルに載せて初めて意味を持つ
AI 可視性データと向き合う際は、「その数字は何を根拠に、何を推定しているのか」という指標への疑いの目と、「メンションとレコメンドを切り分け、ギャップと引用元の内訳を洗い出す」という実行のステップの両方が欠かせません。
そのうえで、これを単発の監査で終わらせず、継続的に計測・改善へつなげられるかどうかが、成果の差を分けます。
📬 INSIGHT CUBEの最新情報をいち早く受け取る
INSIGHT CUBEでは、当社一次情報によるコラムやエージェンティック・コマース、AI検索の最新動向など、デジタルマーケティング責任者が押さえておくべき最新情報を継続的にお届けしています。いち早く情報をキャッチアップし、限定のコンテンツを受け取りたい方はニュースレターへのご登録、SNSでのフォローを是非お願いいたします。
📩 ニュースレターに登録する | 𝕏 Xでフォローする | f Facebookでフォローする
関連記事
「自社で28日間・2,133回 AI 検索の可視性を計測した結果」を公開|LLMOA(エルモア)のサンプルレポートで見る「計測から改善まで」の全プロセス
→ 「自社で28日間・2,133回 AI 検索の可視性を計測した結果」を公開。LLMOA(エルモア)のサンプルレポートで見る「計測から改善まで」の全プロセスを解説しており、本記事の実践例のもとになったレポートの詳細を確認できます。
 AI 検索の計測は、1つのAI プラットフォームでは機能しない|引用91%が示す「計測ギャップ」の実態
→ AI 検索の計測は、1つの AI プラットフォームでは機能しない|引用91%が示す「計測ギャップ」の実態を解説。複数プラットフォームを横断して計測する重要性を、別のデータから補強しています。
よくある質問(FAQ)
- Q. 「AI adjusted volume」とは何ですか?
- A. Ahrefs が採用する独自指標で、Google 検索ボリュームを基準に、AI プラットフォームごとのトラフィック比率を掛け合わせて AI 検索での需要を推定するものです。AI プロンプトの実測データが公開されていないため、豊富な公開データを持つ Google 検索を推定の拠り所にしています。
- Q. AI 検索における「メンション」と「レコメンド」の違いは何ですか?
- A. メンションは、AI の回答内でブランド名が言及されている状態です。レコメンドは、買い手が検討すべき選択肢として実際に提示されている状態です。メンションされる頻度が高くても、レコメンドされる頻度はほとんどないというケースがあり、ビジネスの成果に直結するのはレコメンドです。
- Q. 自社でAI可視性を監査するには何から始めればよいですか?
- A. まず Search Console から商業意図の強いクエリを抽出し、AI への自然な質問文に書き換えます。それを複数の AI エンジンで実行して回答を記録し、メンション率・レコメンド率・シェアオブボイスを算出したうえで、ギャップリストと引用元の内訳を洗い出す、という4ステップで進められます。
- Q. 手作業での監査にはどんな限界がありますか?
- A. 複数の AI モデルに複数のプロンプトを実行し、回答を記録・分類する作業を日次・週次で継続するのは負荷が大きく、現実的に難しいという限界があります。AI 検索の露出状況は日々変化するため、単発の監査で終わらせず、継続的な計測と改善のサイクルに載せる仕組みが必要です。
参照・引用出典
- Ahrefs Blog「AI adjusted volume: How Ahrefs approaches the challenge of estimating AI Search demand」(Constance Tan、2026年8月17日)
- Search Engine Journal「How To Measure Your Brand’s Visibility In AI Answers (And Fix What You Find)」(Lauren Parker、2026年9月4日、HubSpot 協賛記事)
- INSIGHT CUBE「『自社で28日間・2,133回 AI 検索の可視性を計測した結果』を公開|LLMOA(エルモア)のサンプルレポートで見る『計測から改善まで』の全プロセス」(2026年8月10日)