
【記事の要約(ここだけでもポイントは掴めます)】
AI に同じ質問をしても、AI の回答に自社名が出るかどうかは毎回変わります。21サービス・25,281回の回答を同じ質問ごとに並べると、1回の確認で判断することの危うさがはっきりしました。
- 自社名が毎回出る質問は3.0%: 半数以上の質問では、自社名が出る日と出ない日がありました
- 1回の計測は平均26ポイントずれる: 10回測っても7ポイントのずれが残ります
- 同じ月の中でも約4分の1の質問が10ポイント以上動く: 一方、質問を合計した言及率はほとんど動きません
- AI は悪く言わない: 自社名が出た回答の94.6%がポジティブで、ネガティブは1回だけでした
- 自社名が出るときは競合と一緒: 競合が登場した回答では、自社の言及率が2.4倍でした
AI の回答のモニタリングは、質問ごとに10回以上計測し、複数の質問を合計した数値で判断することが最初の一歩です。
AI 検索の時代に SEO の何が変わったのかは「AI時代のSEOとは|「SEOは終わった」は誤解、変わったのは評価のルール」で整理しています。言及率などの指標の定義と計測の手順は「AI引用率の計測方法|生成AIの言及率を自社で測る4ステップ」をご覧ください。
なお、本記事は、「AI ビジビリティスコア(可視性スコア)は1回の計測では信頼できない」で紹介した海外の研究の結論を、日本企業の実測データで検証した続編記事です。実測データの詳細は以下となります。
本記事のデータは、株式会社グラッドキューブが提供する AIO・LLMO 対策プラットフォーム LLMOA(エルモア)で計測した21サービスの回答データ(2026年3〜9月計測、回答総数25,281回)に基づいています。計測は、同じ質問を同じ AI モデルに1日1回ずつ、約30〜90日間繰り返したものです。各データは個別企業を対象とした匿名化データで、各業界全体の傾向を代表するものではありません。生成 AI の回答はアルゴリズムの変動によって短期間で変わるため、今後も同じ傾向が続くとは限りません。
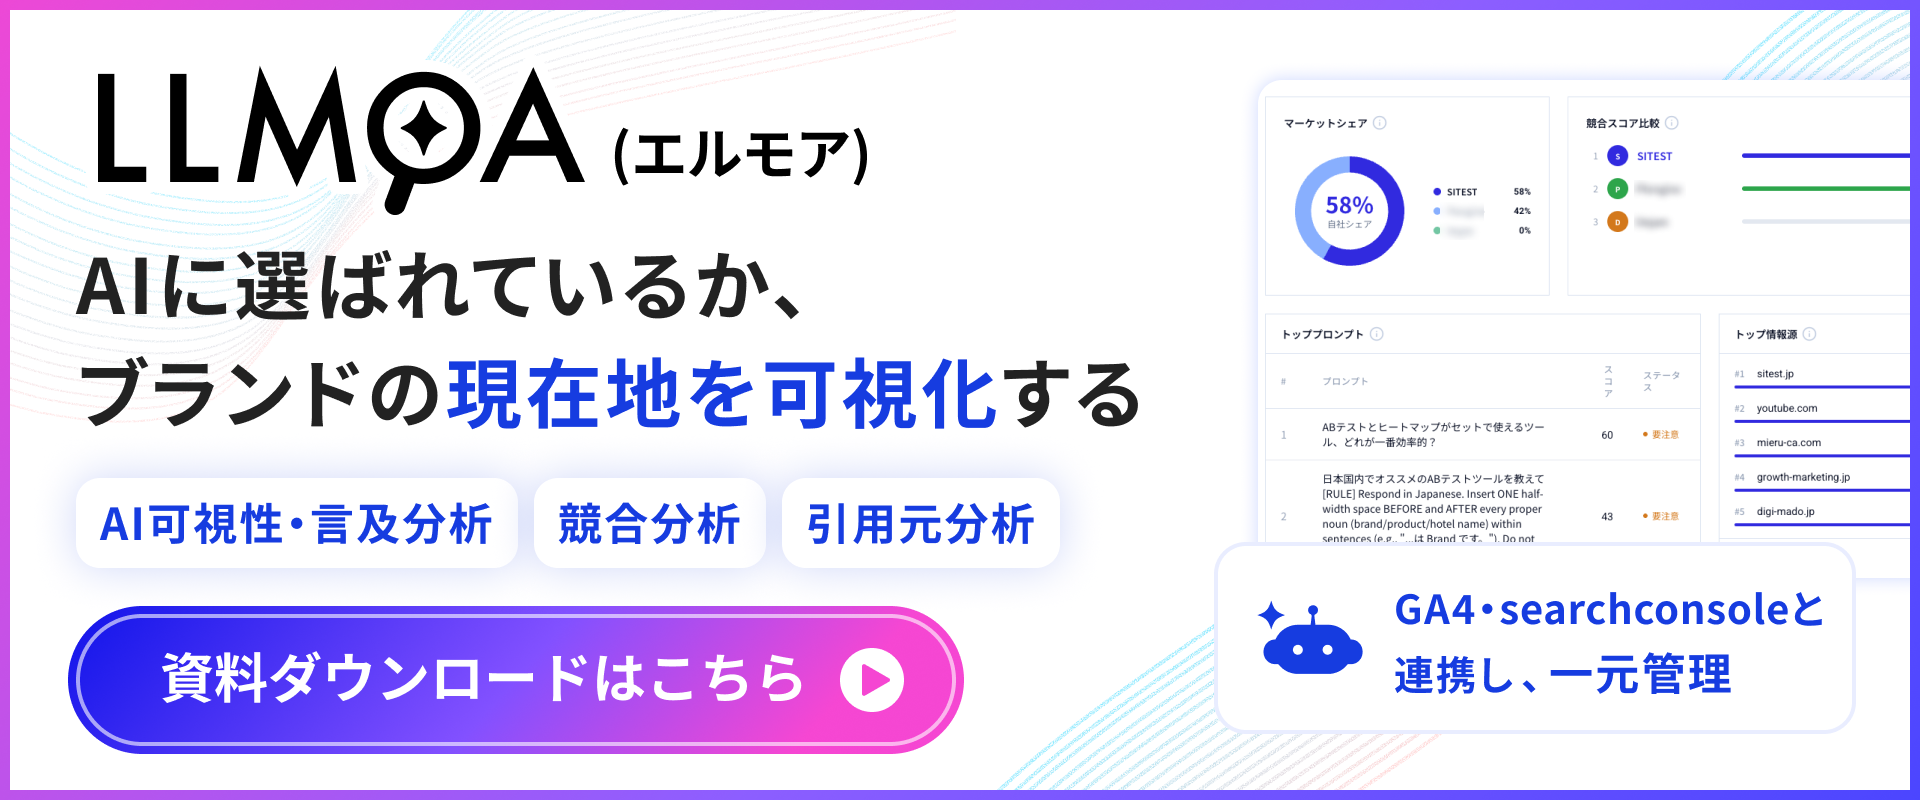
結論:同じ質問でも、AIの回答は毎回変わる
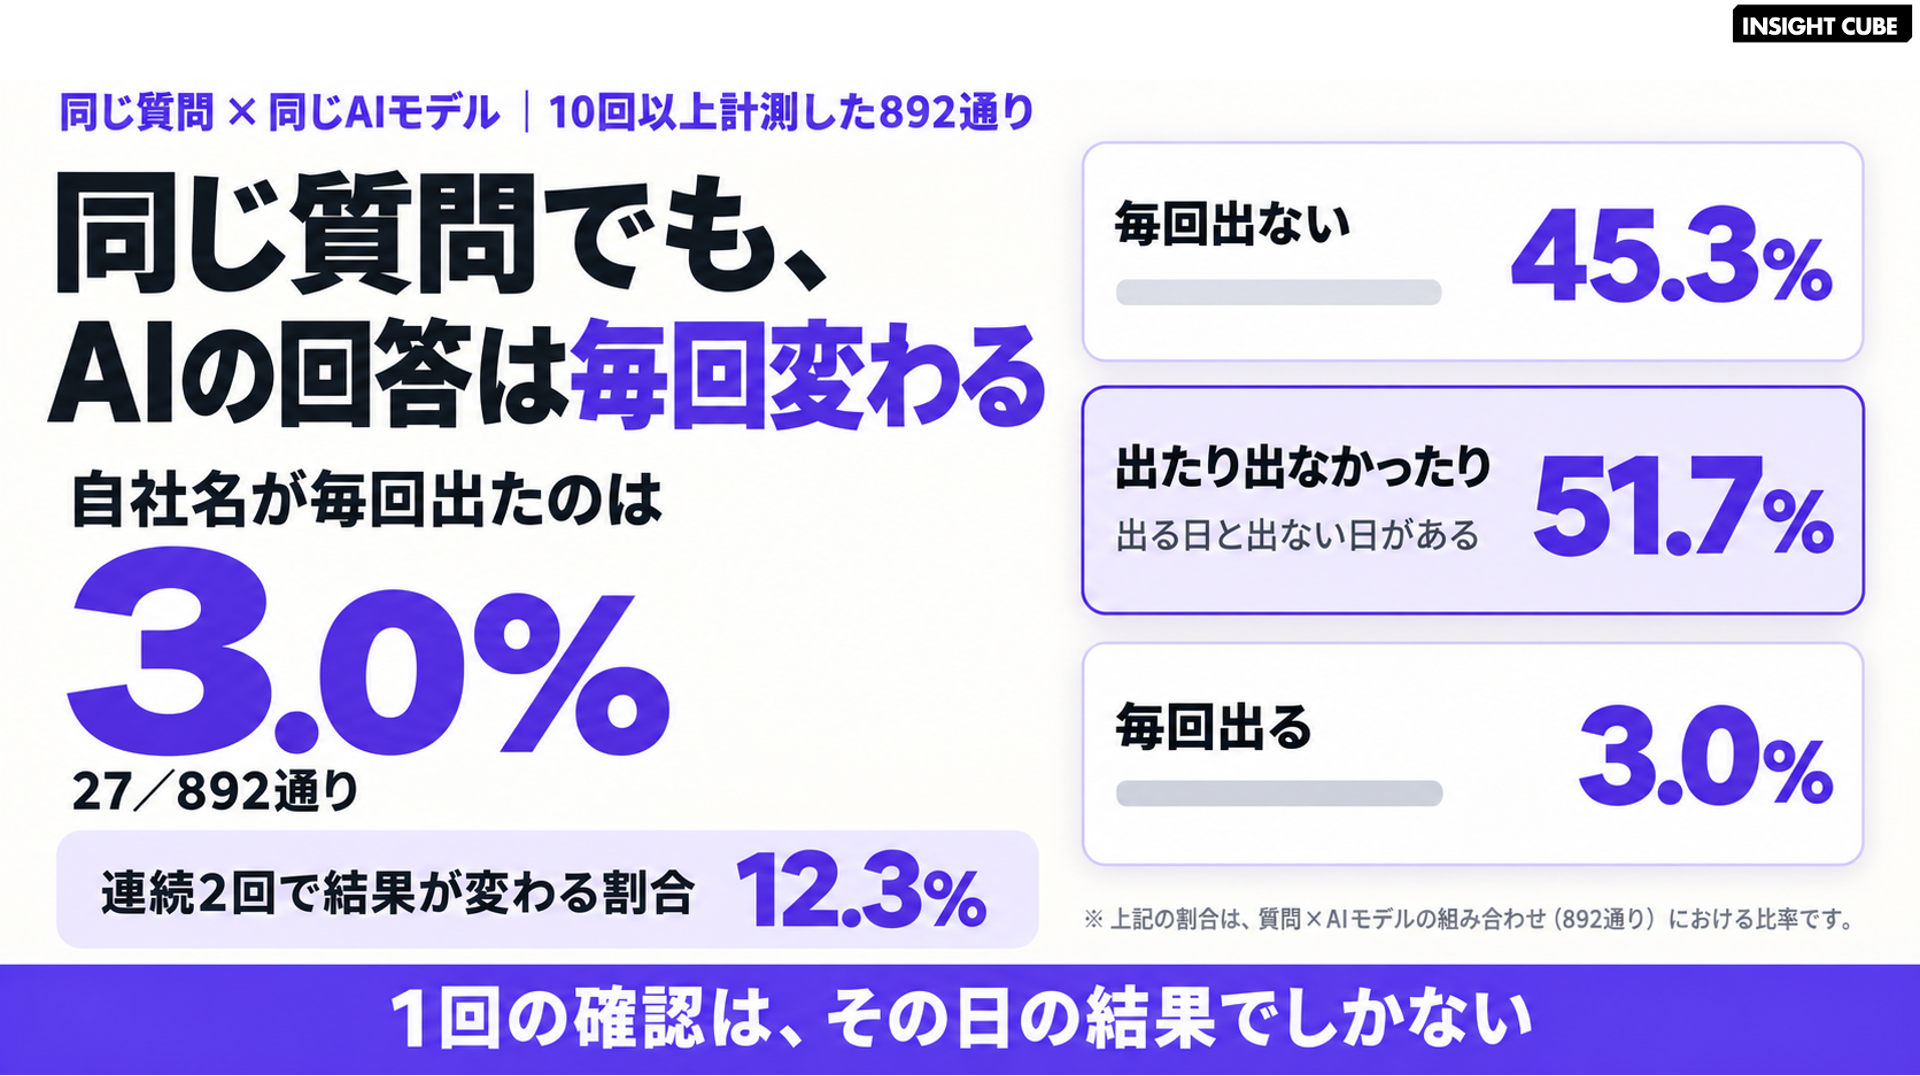
自社名が毎回出たのは3.0%、半数以上は出たり出なかったり
本記事では、ある1つの質問を1つの AI モデルに繰り返し聞いた結果を「1通り」と数えます。たとえば「初心者におすすめのジムはどこ?」という質問を ChatGPT に30日間、毎日1回ずつ聞いた結果が1通りです。
10回以上計測した892通りについて、自社名が出た割合(言及率:Mention Rate)を調べると、次のように分かれました。自社名がどれくらい安定して AI の回答に出ているかを判断するための表です。
| 自社名の出方 | 割合 |
|---|---|
| 毎回出ない(言及率0%) | 45.3% |
| まれに出る(20%未満) | 22.2% |
| 出たり出なかったりする(20〜80%) | 24.3% |
| ほぼ出る(80%超) | 5.2% |
| 毎回出る(100%) | 3.0% |
自社名が毎回出たのは、892通りのうち27通り(3.0%)だけでした。一度も出なかったのは45.3%で、残りの51.7%は、同じ質問を同じ AI に聞いても、自社名が出る日と出ない日がありました。
つまり、担当者が AI に一度質問して「自社が出ていた」「出ていなかった」と確認しても、それはその日の1回分の結果でしかないということです。
連続する2回の計測で、結果が変わる割合は12.3%
前日と今日のように、連続する2回の計測で「自社名が出た/出なかった」が入れ替わった割合は、全体で 12.3% でした。AI モデル別では次のとおりです。
| AI モデル | 連続2回で 結果が変わる割合 | 「出たり出なかったりする」 質問の割合 |
|---|---|---|
| Gemini | 17.3% | 32.4% |
| Google AI モード | 13.0% | 30.8% |
| ChatGPT | 11.0% | 22.5% |
| Google AI Overviews | 10.1% | 19.7% |
| Perplexity | 9.9% | 15.5% |
Gemini と Google AI モードは、回答が特に揺れやすいモデルであることもわかりました。AI モデルごとの言及率の違いについては「同じ質問でも AI モデルによって言及率は平均12倍差」で詳しく解説しています。
なお、質問の型によっても安定性は大きく違います。質問に自社名を含む「指名」の質問では37.0%が毎回自社名が出た一方、候補を挙げさせる「推薦型」の質問では1.4%、用語や方法を説明させる「解説型」の質問では0%でした。
つまり、AI 対策で最も重要な推薦型の質問ほど、回答が揺れやすいということです。
AIの回答は何回計測すれば信頼できるのか
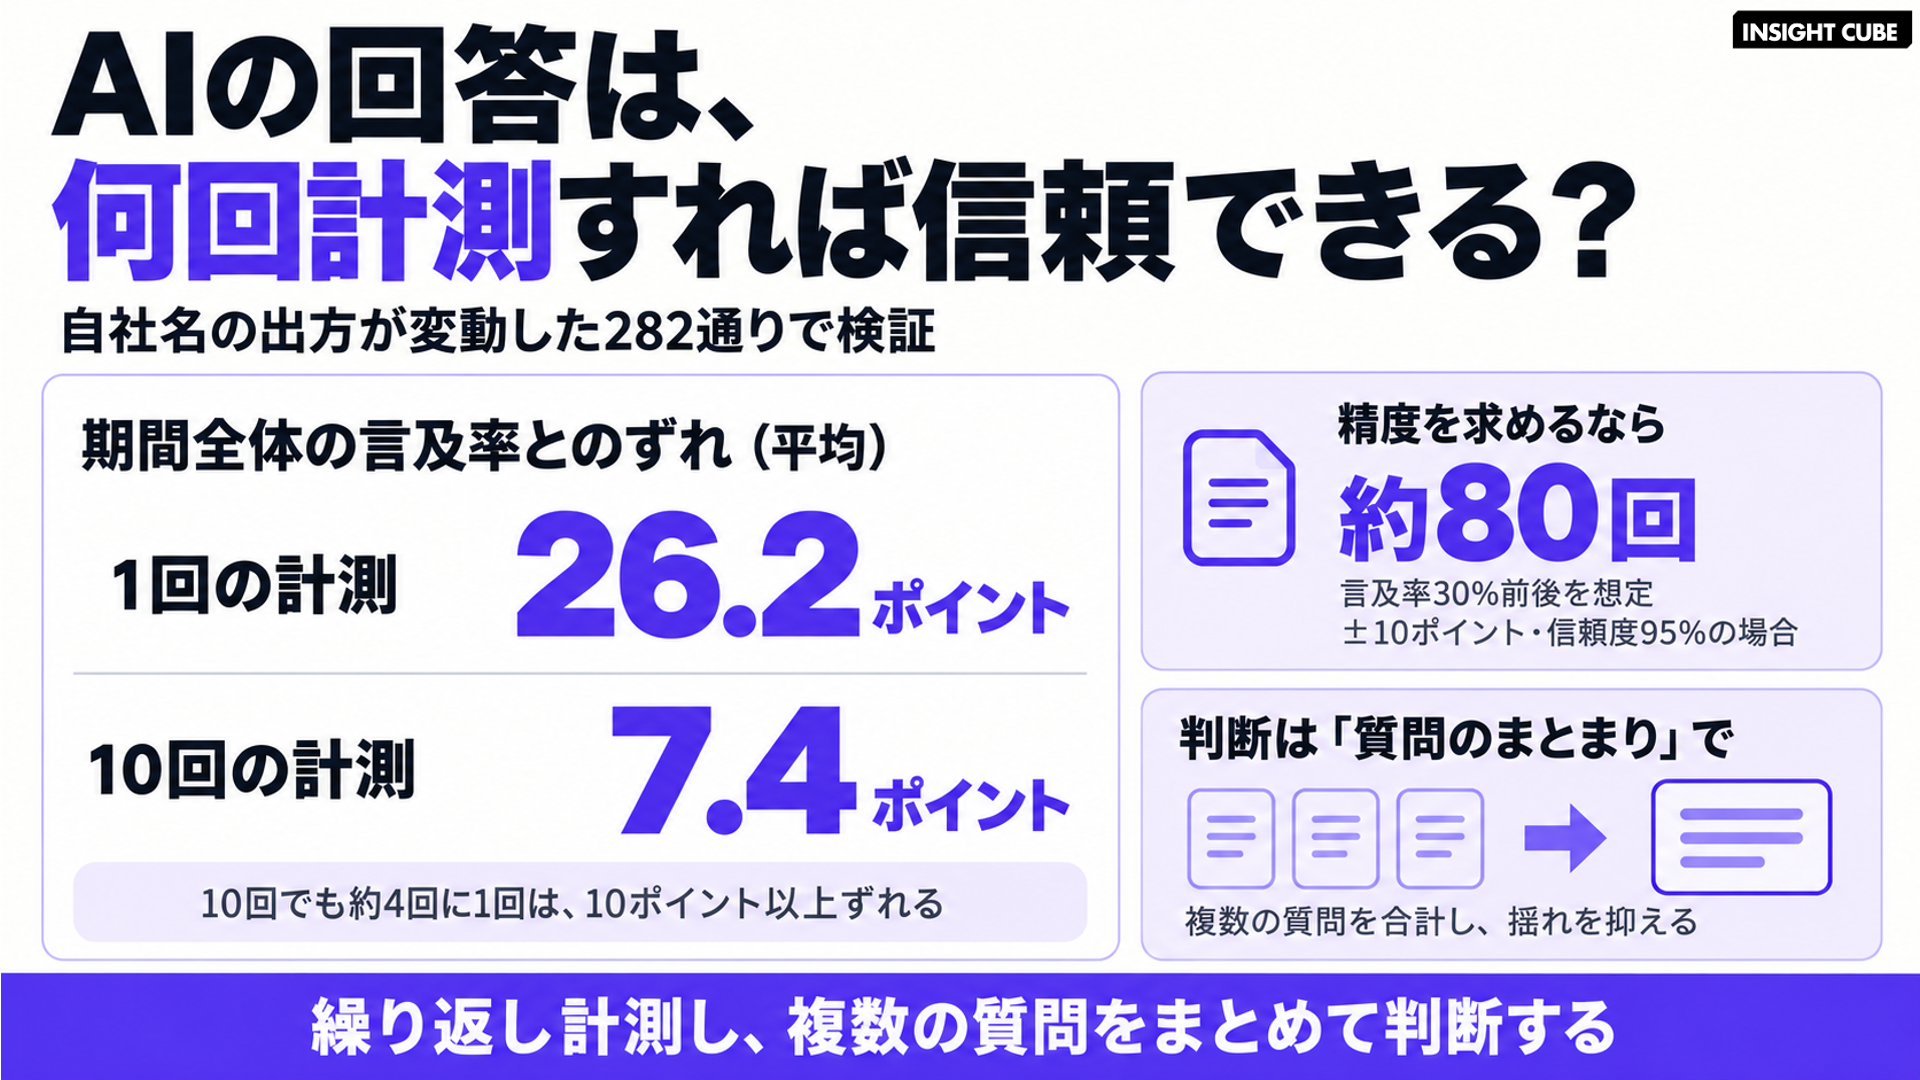
1回の計測は期間全体の言及率から平均26.2ポイントずれる
では、何回測れば実態に近い数字になるのでしょうか。25回以上計測した質問のうち、前の章で見た「自社名が出たり出なかったりした」282通りを使って確認しました。毎回出る、または毎回出ない質問は、何回測っても結果が同じなので、対象外にしています。
それぞれの質問について、計測結果から無作為に数回分を抜き出し、その回数分だけで計算した言及率が、期間全体の言及率とどれだけずれるかを調べています。少ない回数で測ったときに、どれくらい判断を誤るかを見るための表です。
| 計測回数 | 期間全体の言及率とのずれ(平均) | ずれが±10ポイント以内に収まる確率 |
|---|---|---|
| 1回 | 26.2ポイント | 35.4% |
| 3回 | 15.3ポイント | 46.4% |
| 5回 | 11.7ポイント | 53.9% |
| 10回 | 7.4ポイント | 75.1% |
1回の計測では、ずれが±10ポイントに収まる確率は約3分の1しかありません。10回測っても、4回に1回は10ポイント以上ずれます。
統計の計算でも同じ結論になります。言及率30%前後の質問を、±10ポイントの精度(95%の信頼度)で測るには、約80回の計測が必要です。
海外の研究が示した「33〜94件」と一致する
「AI ビジビリティスコア(可視性スコア)は1回の計測では信頼できない」では、海外の研究として、信頼できる計測には AI プラットフォームによって33〜94件の回答が必要だという結果を紹介しました。
今回の LLMOA の実測データでも、10回程度ではまだずれが大きく、数十回の計測が必要だという結果になりました。海外の研究の結論は、日本語の質問・日本企業のデータでも当てはまるということです。
同じ月の中でも、約4分の1の質問で言及率が10ポイント以上動く
計測期間(約30日)を前半と後半に分けて、同じ質問の言及率を比べました。20回以上計測した629通りのうち、22.9%で前半と後半の差が10ポイント以上、12.4%で20ポイント以上ありました。
この差には、期間中のサイトの変更などによる本当の変化も含まれている可能性があります。それでも、施策をしていなくても1か月の中で数字がこれだけ動く以上、「先月より言及率が3ポイント上がった」という報告は、ほとんど意味を持たないと考えるべきです。
質問を合計した言及率は、ほとんど動かない
一方で、サービスごとに全部の質問を合計した言及率を、同じように前半と後半で比べると、差の中央値は0.0ポイントでした。21サービスのほとんどで、差は±2ポイント前後に収まっています。
1つひとつの質問の結果は大きく揺れても、数十の質問を合計すれば揺れは打ち消し合います。判断の単位を「質問1つ」ではなく「質問のカテゴリ」にすることで、AI の回答の揺れに振り回されずに済みます。
どんな「質問のカテゴリ」を計測すればよいのか?
質問のカテゴリの作り方は、業種によって変わります。主な切り口は次の4つです。
| カテゴリの切り口 | 考え方 | BtoB ツールの例 | 店舗型サービスの例 | 通販・EC の例 |
|---|---|---|---|---|
| ① 機能・商品の種類 | 自社が扱う商品・機能ごとに質問を作る | 「◯◯ツールのおすすめは?」を機能ごとに | 「パーソナルジム」「24時間ジム」など業態ごとに | 商品の種類ごとに「◯◯のおすすめは?」 |
| ② 悩み・利用シーン | 顧客が困っていることから質問を作る | 「CVR を上げたい」「問い合わせを増やしたい」 | 「運動不足を解消したい」「ダイエットしたい」 | 「敏感肌でも使える」「プレゼントに」 |
| ③ 条件 | 価格・地域・対象者などの条件を加える | 「中小企業向け」「無料で使える」 | 「◯◯駅の近く」「初心者向け」「月額が安い」 | 「1万円以下」「送料無料」 |
| ④ 比較・検討 | 他社と比べる段階の質問を作る | 「◯◯と△△の違いは?」 | 「◯◯ジムと△△ジムはどちらがいい?」 | 「人気ブランドを比較して」 |
カテゴリを作るときは、次の2点に注意してください。
- 自社名を含む質問(指名)、候補を挙げさせる質問(推薦型)、仕組みを説明させる質問(解説型)は、同じカテゴリに混ぜない: 前の章で見たとおり、指名の質問は毎回自社名が出やすく、解説型の質問はほとんど出ません。混ぜると、カテゴリの言及率が質問の配分しだいで変わってしまいます
- 1つのカテゴリの回答数を十分に確保する: たとえば、5問×5つの AI モデル×10日で250回になります。言及率30%前後なら、統計上の誤差は±6ポイント程度まで小さくなります(同じ質問の回答同士は似た結果になりやすいため、実際の誤差はこれより大きくなることがあります)
こうしてカテゴリを作っておくと、「機能 A のカテゴリは上がったが、地域名を含むカテゴリは下がった」というように、どの領域で AI の回答での見え方が変わったのかを、揺れに惑わされずに判断できます。
このように1つのカテゴリに最低でも5問〜10問を登録し、50プロンプト程度を計測・検証対象にすることをまずはおすすめします。
AIの回答での順位も、毎回変わるのか
1位を取ったことがある質問でも、毎回1位だったのは25.1%
結論、毎回変わる可能性が高いです。
実際に調査すると、自社名が5回以上出た329通りのうち、毎回同じ順位だったのは22.8%でした。順位の幅(最も高い順位と最も低い順位の差)が3以上あったものは38.6%です。
一度でも1位を取った295通りに絞っても、毎回1位だったのは25.1%でした。「AI に1位で紹介された」という確認結果も、その日の1回分にすぎません。自社名が出たときの順位については「「出れば1位」でも「出現率」は上がらない」の記事も参考にしてください。
AIの回答は、自社をネガティブに言及するか
自社名が出た4,355回のうち、ネガティブは1回だけ
AI が自社をどう紹介しているかも調べました。自社名が出た4,355回の回答のうち、ポジティブな紹介が94.6%、中立が5.4%で、ネガティブは1回だけでした。
AI モデル別でも、ポジティブの割合は Google AI モードの97.1%から Perplexity の88.2%まで、いずれも9割前後です。
怖いのは悪く言われることより、自社名が出ないこと
「AI に自社のことを悪く書かれるのではないか」と心配する声はよく聞きます。しかし今回のデータでは、AI は自社名を出すときにはほとんど好意的に紹介していました。
より大きな問題は、そもそも自社名が出ないことです。前述のとおり、10回以上計測した質問の45.3%では、一度も自社名が出ませんでした。AI 対策で優先すべきは、悪評への備えより、自社名が出る回数を増やすことだということです。
なお、悪意のある第三者が AI の回答を操作しようとするリスクについては「あなたのAI回答は汚染されているかもしれない」で解説しています。
AIの回答に自社名が出やすいのは、どんなときか
競合が登場した回答では、自社の言及率が2.4倍の30.9%
推薦型の質問で、計測時に競合として登録していた企業(各サービス3社)の名前が回答に出たかどうかで分けて、自社の言及率を比べました。
| 回答に出た競合の数 | 回答数 | 自社の言及率 |
|---|---|---|
| 0社 | 13,742 | 12.9% |
| 1社 | 2,965 | 25.1% |
| 2社 | 1,366 | 35.7% |
| 3社 | 1,265 | 39.5% |
競合が1社でも出た回答では自社の言及率が30.9%で、出なかった回答(12.9%)の2.4倍でした。出てくる競合が多いほど、自社の言及率も上がっています。
質問の内容による違いを除くため、同じ質問・同じ AI モデルの回答同士で比べても、競合が出た回答のほうが自社の言及率は平均11.5ポイント高い結果でした。5つの AI モデルすべてで同じ傾向です。
勝負は1位争いの前に「比較の候補に入れるか」
AI は、おすすめを回答するときに候補を「まとめて」挙げる傾向があります。
競合の名前が出るような回答は、AI がその分野の選択肢を比べて紹介している回答です。つまり、そうした回答では、自社も候補の一つとして一緒に挙がりやすくなります。
逆に言えば、自社名が出ない回答の多くは、そもそも AI がその分野の企業を比べて紹介していない回答です。
まず競合と並んで比較される候補に入ることが、順位を上げるより先の課題だということです。
LLMOの効果測定で、今すぐできる3つのこと
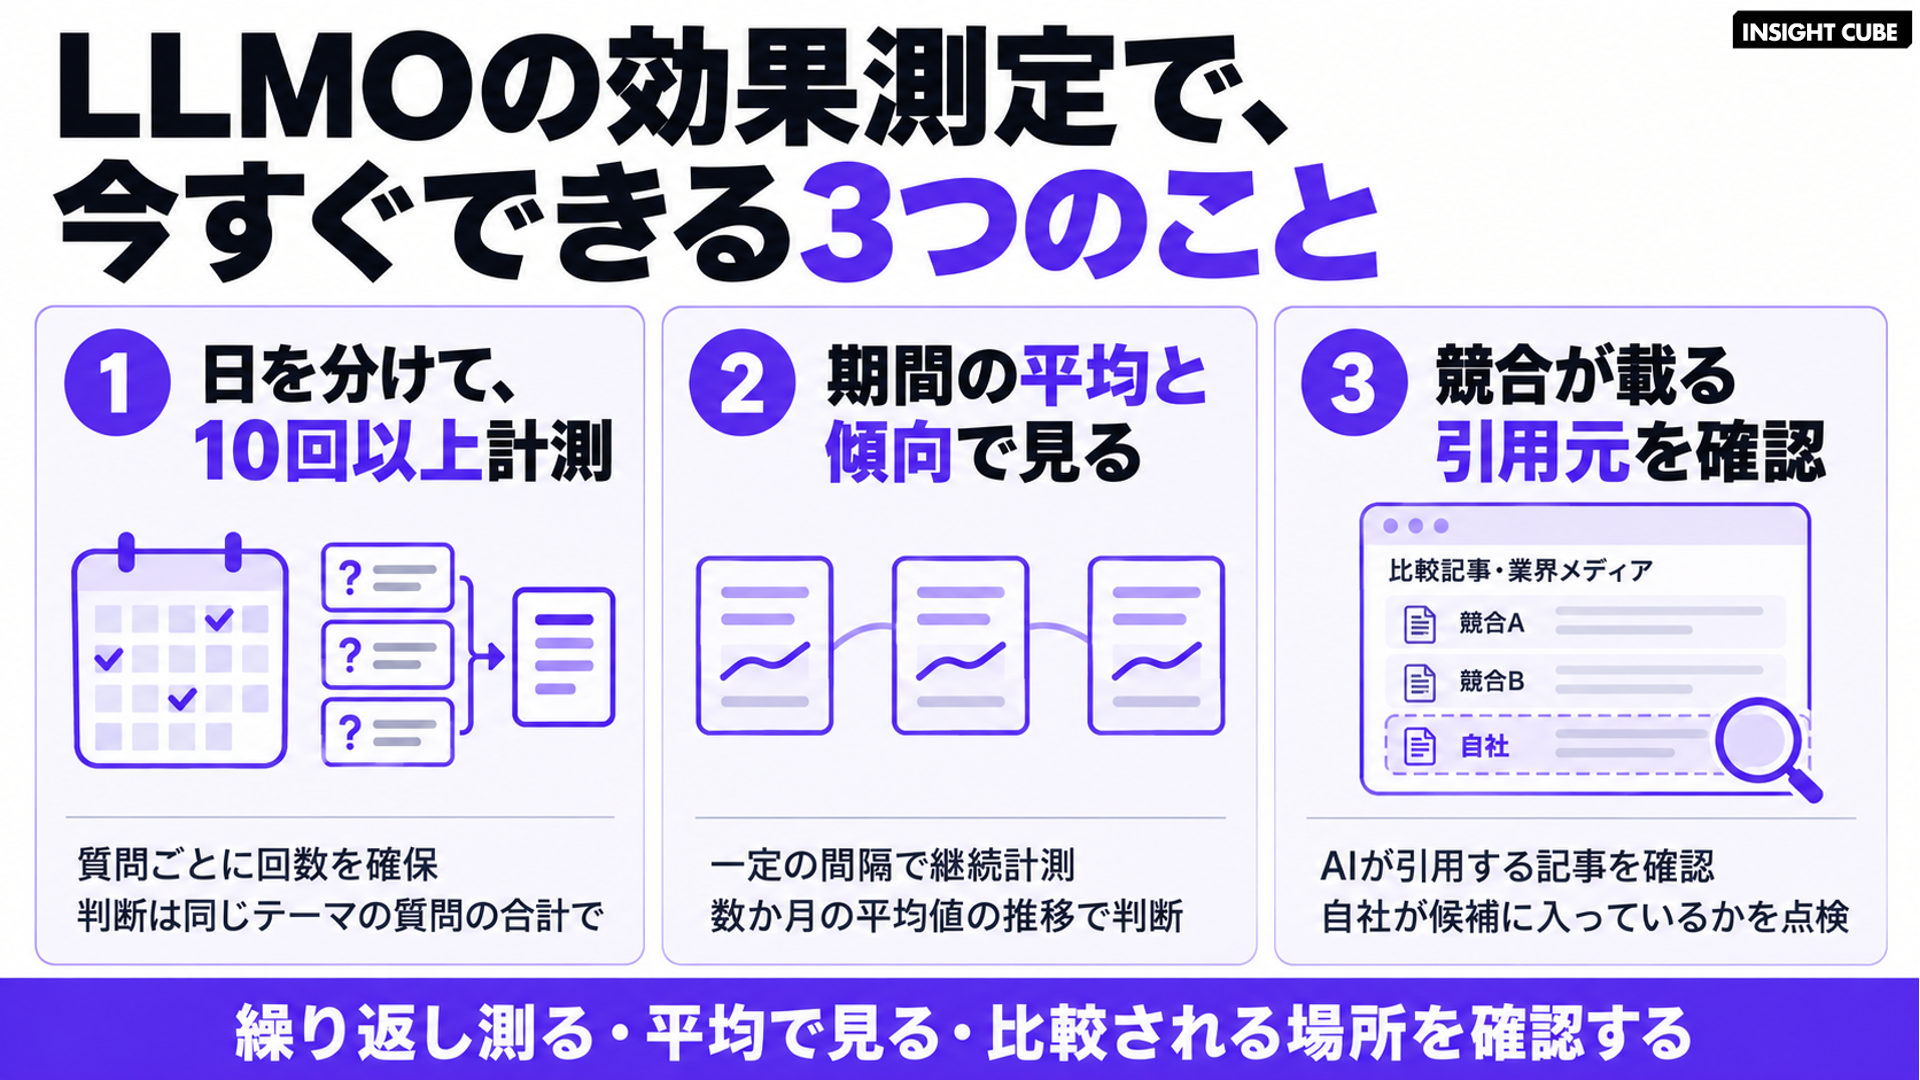
① 質問ごとに10回以上計測し、判断は複数の質問の合計で行う
1回の確認で「出ていた」「出ていなかった」と判断するのはやめましょう。1回の計測は平均26.2ポイントずれます。
質問ごとに少なくとも10回以上、できれば数十回計測してください。そのうえで、施策の効果は質問1つの数字ではなく、同じテーマの質問を合計した言及率で判断します。質問を合計した言及率なら、1か月の中でもほとんど動きませんでした。
1日に10回まとめて計測するのと、1日1回を10日間続けるのは、どちらがよいのか?
おすすめは、1日1回(または数回)を、10日以上に分けて続ける方法です。AI の回答は、日が変わらなくても1回ごとに揺れています。
そのため、揺れをならすだけなら、1日にまとめて計測しても回数を稼ぐことはできます。ただし、AI の回答は、参照する Web ページの更新や AI モデルの更新によって、日ごとにも変わります。1日にまとめて計測すると、その日だけの状態を何度も測ることになり、数日〜数週間かけて起きる変化をとらえられません。回数を確保しつつ、計測する日を分散させることで、偶然の揺れと本当の変化の両方を見られるようになると考えます。
② 「先月比」ではなく、期間の平均と傾向で見る
同じ月の中でも、約4分の1の質問で言及率が10ポイント以上動いていました。月に1回測って前月と比べる方法では、施策の効果と偶然の揺れを区別できません。
毎日など一定の間隔で計測を続け、期間の平均値が数か月にわたってどう動いているかで判断してください。報告の際も、「先月より何ポイント上がった」ではなく、「この3か月の平均がどう推移したか」を示すほうが正確です。
③ 競合と並んで比較される場所に、自社の情報を置く
競合が登場する回答ほど、自社名も出やすくなっていました。AI が業界の選択肢を比べて紹介する場面で、自社が候補に入っていることが重要です。
具体的には、自社のテーマで AI が引用しているランキング・比較記事や業界メディアを確認し、競合が載っているのに自社が載っていないものがないかを洗い出してください。AI が何を引用しているかの調べ方は「AIの引用元ランキング」で解説していますので参考にしてください。
LLMOA で、AI の回答を毎日モニタリングする
AI の回答は毎回変わるため、正しく把握するには、同じ質問を繰り返し計測し続ける必要があります。手作業で毎日、複数の AI モデルに同じ質問をするのは現実的ではありません。
グラッドキューブの LLMOA(エルモア)は、登録した質問を主要5つの AI モデルで自動的に計測し続け、言及率や順位の推移、競合との比較を確認できます。1回の確認ではなく、期間の平均と傾向で AI の回答での自社の見え方を判断する起点として活用できます。
調査の概要と注意点
21サービス・5モデル・回答25,281回を、質問ごとに追跡
| 項目 | 内容 |
|---|---|
| 計測ツール | LLMOA(エルモア): https://llmoa.ai/ |
| 計測期間 | 2026年3〜9月(サービスごとに約30〜90日間) |
| 対象 | 21サービス(BtoB 6サービス・BtoC 15サービス) |
| AI モデル | Google AI Overviews、Google AI モード、ChatGPT(gpt-4o-mini)、Gemini(gemini-2.5-flash)、Perplexity(sonar) |
| 回答数 | 25,281回(質問×AI モデルの組み合わせ1,215通り、1日あたり平均1.01回) |
| 分析の対象 | 安定性:10回以上計測した892通り。計測回数とずれ:25回以上計測し、言及が変動した282通り |
- 計測回数とずれの分析について: 1つの質問の計測回数は25〜72回のため、抜き出す回数を増やすほど、期間全体の値とのずれは小さく出やすくなります。そのため、本記事では10回までの結果を示しています。
- 前半と後半の比較について: 偶然の揺れだけでなく、期間中のサイトの変更などによる本当の変化も含まれている可能性があります。
- 感情の判定について: ポジティブ・中立・ネガティブは、LLMOA の自動判定によるものです。
- 競合の判定について: 計測時に各サービスが競合として登録した3社の名前が、回答の本文に含まれているかどうかで判定しました。競合を登録していた20サービスの推薦型の質問が対象です。
- その他: ChatGPT・Gemini・Perplexity は API 経由で計測しており、一般向けのアプリの回答とは異なる場合があります。ここで示した関係は相関であり、因果関係を確かめたものではありません。
まとめ:AIの回答は、1回ではなく「回数」と「合計」で判断する
- 同じ質問でも AI の回答は毎回変わる。自社名が毎回出た質問は3.0%で、半数以上は出たり出なかったりした。連続2回で回答させた場合、結果が変わる割合は12.3%
- 1回の計測は、期間全体の言及率から平均26.2ポイントずれる。10回でも7.4ポイントのずれが残り、海外の研究の「33〜94件」とも一致した
- 同じ月の中でも、約4分の1の質問で言及率が10ポイント以上動く。一方、質問を合計した言及率はほとんど動かない
- AI は基本的にはネガティブに言及しない。自社名が出た回答の94.6%がポジティブで、ネガティブは1回だけ。課題は自社名が出ないこと
- 競合が登場した回答では、自社の言及率が2.4倍になる。まず競合と並んで比較される候補に入ることが重要
AI に一度聞いて一喜一憂するのではなく、繰り返し計測した数字を、質問のまとまりと期間の平均で見ることが、AI 対策の正しい出発点です。
📬 INSIGHT CUBEの最新情報をいち早く受け取る
INSIGHT CUBEでは、当社一次情報によるコラムやエージェンティック・コマース、AI検索の最新動向など、デジタルマーケティング責任者が押さえておくべき最新情報を継続的にお届けしています。いち早く情報をキャッチアップし、限定のコンテンツを受け取りたい方はニュースレターへのご登録、SNSでのフォローを是非お願いいたします。
📩 ニュースレターに登録する | 𝕏 Xでフォローする | f Facebookでフォローする
関連記事
- AI ビジビリティスコア(可視性スコア)は1回の計測では信頼できない|統計的ノイズ問題と正しい計測設計 を解説。本記事の前提となった海外の研究と、「停止ルール」による計測設計を確認できます。
- 同じ質問でも AI モデルによって言及率は平均12倍差|LLMOA(エルモア)が計測した9業種データで見るAIモデル間格差の実態 を解説。AI モデルごとに言及率がどれだけ違うかを確認できます。
- 「出れば1位」でも「出現率」は上がらない|LLMOA(エルモア)が計測した11サービス分野データが示す共通課題 を解説。自社名が出たときの順位と、言及率そのものを分けて見る必要性を確認できます。
よくある質問(FAQ)
- Q. AIに同じ質問をすると、毎回同じ回答が返ってきますか?
- A. 返ってきません。LLMOA で計測した21サービス・25,281回の回答では、自社名が毎回出た質問は3.0%だけで、半数以上の質問では自社名が出る日と出ない日がありました。連続する2回の計測でも、12.3%の割合で結果が入れ替わっていました。
- Q. AIの回答のモニタリングは、何回計測すれば信頼できますか?
- A. 少なくとも10回以上、できれば数十回の計測が必要です。LLMOA の実測では、1回の計測は期間全体の言及率から平均26.2ポイント、10回でも7.4ポイントずれました。言及率30%前後を±10ポイントの精度で測るには、統計上約80回が必要です。
- Q. AIでの言及率を前月と比べて評価してもよいですか?
- A. 質問1つの前月比で評価するのはおすすめしません。同じ月の中でも、約4分の1の質問で言及率が10ポイント以上動いていました。一方、複数の質問を合計した言及率はほとんど動かないため、質問のまとまりの期間平均で判断するのが適切です。
- Q. AIに自社のことを悪く(ネガティブに)言及されることはありますか?
- A. 今回の計測ではほとんどありませんでした。自社名が出た4,355回の回答のうち、ポジティブな紹介が94.6%、中立が5.4%で、ネガティブは1回だけでした。悪評よりも、そもそも自社名が出ないことのほうが大きな課題です。
- Q. AIの回答に自社名が出やすくなるのは、どんなときですか?
- A. 競合の名前が一緒に出る回答です。推薦型の質問では、競合が登場した回答の自社の言及率は30.9%で、登場しなかった回答(12.9%)の2.4倍でした。競合と並んで比較される候補に入ることが重要です。
- Q. AIの回答は、1日に何回もまとめて計測するのと、毎日1回ずつ計測するのと、どちらがよいですか?
- A. 1日1回(または数回)を、10日以上に分けて計測するのがおすすめです。LLMOA の計測では、同じ日の回答同士でも自社名が出たかどうかが12.3%食い違っており、AI の回答は1回ごとに揺れています。さらに、参照する Web ページや AI モデルの更新によって日ごとにも変わるため、計測する日を分散させることで、偶然の揺れと本当の変化の両方をとらえられます。
参照・引用出典
一次情報(株式会社グラッドキューブ 自社調査)
本記事のデータは、株式会社グラッドキューブが提供する AIO・LLMO 対策プラットフォーム「LLMOA(エルモア)」で計測した自社調査の結果です(2026年3〜9月計測時点)。サービス名は匿名化しており、個別の測定条件は非開示です。質問の型(指名・推薦型・解説型)は、編集部が質問文の内容から分類しました。
- グラッドキューブ調べ(LLMOA 計測):21サービス・5 AI モデルの回答データ(回答総数25,281回、質問×AI モデル1,215通り)。10回以上計測した892通りの言及の出方(毎回出る3.0%、毎回出ない45.3%、出たり出なかったり51.7%)、連続2回で結果が変わる割合12.3%
- グラッドキューブ調べ(LLMOA 計測):25回以上計測し言及が変動した282通りの、計測回数別の言及率のずれ(1回26.2ポイント、10回7.4ポイント)。計測期間の前半・後半での言及率の差(20回以上計測した629通りの22.9%で10ポイント以上、サービス合計の差の中央値0.0ポイント)
- グラッドキューブ調べ(LLMOA 計測):自社名が5回以上出た329通りの順位の安定性、1位を取った295通りのうち毎回1位25.1%
- グラッドキューブ調べ(LLMOA 計測):自社名が出た4,355回の感情(ポジティブ94.6%、中立5.4%、ネガティブ1回)。LLMOA の自動判定
- グラッドキューブ調べ(LLMOA 計測):競合を登録した20サービスの推薦型の質問における、競合の登場数別の自社の言及率(0社12.9%〜3社39.5%)、同一質問×同一 AI モデル内の差(424通り、平均11.5ポイント)